
Un local AI stack productif, c’est une pile simple à maintenir, pas juste un modèle lancé sur votre machine. Je vais partir du moteur local, passer par VS Code, puis montrer comment garder un SLM utile, rapide et fiable dans un vrai workflow de dev.
Pourquoi une pile locale change tout ?
Un SLM, c’est un petit modèle de langage. Petit ne veut pas dire faible. Ça veut dire plus facile à faire tourner sur votre machine, avec moins de latence, moins de coût, et plus de contrôle sur vos données.
Faire tourner un modèle local aujourd’hui, c’est devenu simple. On installe Ollama, LM Studio ou llama.cpp, on télécharge un modèle, et ça répond. Le piège, c’est de croire que ça suffit. La productivité ne vient pas juste du modèle. Elle vient de la pile autour.
Je vois souvent des équipes faire le même test. Elles lancent un modèle local, elles posent trois questions, elles sont bluffées pendant 20 minutes. Puis elles abandonnent. Pourquoi ? Parce que rien n’est branché à leur vrai workflow. Pas d’accès au code. Pas d’éditeur. Pas de fichiers projet. Pas de tests. Donc ça reste une démo sympa, pas un outil de travail.
Pour qu’un SLM devienne utile, je garde quatre couches en tête.
- Le moteur de service local sert à exécuter le modèle et exposer une API locale. C’est le socle.
- L’interface éditeur permet d’utiliser le modèle là où je travaille déjà, dans VS Code, Cursor, Continue ou un autre outil.
- La connexion aux outils et fichiers donne du contexte réel au modèle. Sans ça, il devine trop.
- Le contrôle qualité valide ce que le modèle produit avec des tests, du linting, des revues et des règles claires.
Le matériel compte aussi, mais il ne faut pas le regarder seul. Un CPU peut suffire pour tester. La RAM limite la taille du modèle et du contexte. La VRAM est critique si vous utilisez un GPU NVIDIA. Sur Apple Silicon, la mémoire unifiée aide beaucoup, surtout avec des modèles quantifiés. La quantification réduit le poids du modèle, souvent avec une petite perte de qualité. Le contexte, lui, définit combien de texte le modèle peut garder en mémoire pendant une demande.
| Couche | Rôle | Outil typique | Risque si mal choisie |
| Moteur local | Faire tourner le modèle | Ollama, LM Studio, llama.cpp | Latence, incompatibilités, modèles trop lourds |
| Interface éditeur | Travailler sans changer d’environnement | Continue, Cursor, VS Code | Usage gadget, copier-coller permanent |
| Connexion projet | Donner le bon contexte | Fichiers, Git, terminal, docs internes | Réponses vagues ou fausses |
| Qualité | Vérifier avant d’intégrer | Tests, lint, CI, revue humaine | Code cassé, dette technique, fausse confiance |
Quel moteur local choisir ?
Le bon moteur local, je le choisis rarement “sur le papier”. Je pars du matériel, du niveau de contrôle attendu, et surtout du volume de requêtes. Un SLM, c’est un Small Language Model, donc un modèle plus léger qu’un gros LLM, mais il faut quand même le servir proprement si on veut en faire un vrai outil de prod.
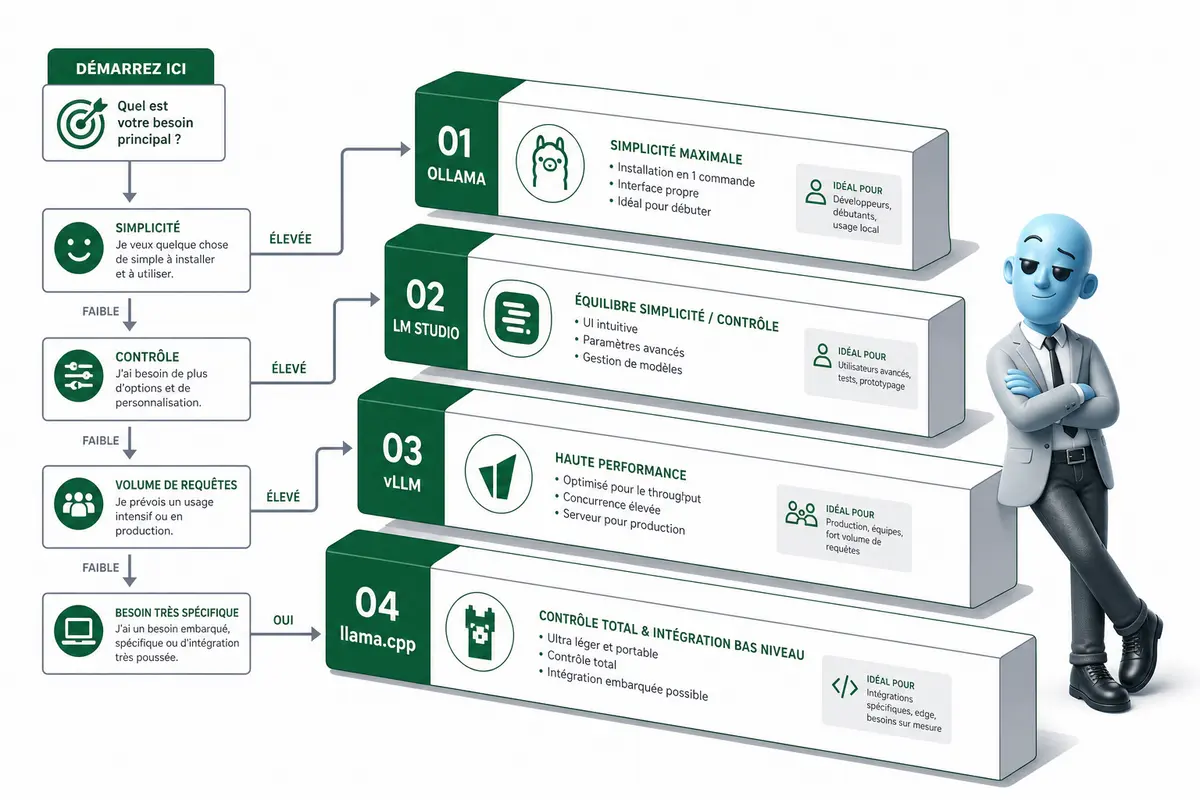
Ollama est souvent mon point de départ. C’est simple, fiable, et ça fait trois choses sans friction : installer, télécharger, puis servir le modèle. Il expose une API REST locale, et selon les usages, des endpoints compatibles OpenAI. Pour brancher un outil low code, un script Python, n8n ou une petite API interne, ça va vite.
# Installe Ollama sous Linux ou macOS
curl -fsSL https://ollama.com/install.sh | sh

# Télécharge un modèle léger et utile
ollama pull llama3.2:3b

# Lance le modèle en local pour un test rapide
ollama run llama3.2:3b
Pour tester l’API locale, je fais souvent un curl tout simple. Ça évite de déboguer une intégration alors que le modèle ne répond même pas.
# Teste l’API REST locale d’Ollama
curl http://localhost:11434/api/generate
  -d '{
    "model": "llama3.2:3b",
    "prompt": "Résume ce texte en 3 bullets.",
    "stream": false
  }'
LM Studio est très pratique quand je veux comparer visuellement plusieurs modèles. On charge un GGUF, on ajuste la température, le contexte, la quantification, puis on expose un serveur local compatible OpenAI. Pour un client, je m’en suis souvent servi comme banc d’essai avant de figer une stack plus propre.
Llama.cpp est plus bas niveau. Il donne un contrôle fin sur les modèles GGUF, la quantification, le contexte, les threads CPU, l’usage GPU. C’est excellent quand on veut optimiser une machine précise. Mais oui, il faut accepter un peu plus de configuration.
# Lance un serveur llama.cpp avec un modèle GGUF
./llama-server
  -m ./models/mistral-7b-instruct.Q4_K_M.gguf
  --host 0.0.0.0
  --port 8080
  -c 4096
VLLM joue dans une autre catégorie. Je le prends quand le sujet devient le débit, les batchs, les requêtes concurrentes, ou un serveur GPU plus costaud. Si vous avez plusieurs utilisateurs ou une API interne bien sollicitée, ça devient intéressant.
# Lance un serveur compatible OpenAI avec vLLM
python -m vllm.entrypoints.openai.api_server
  --model mistralai/Mistral-7B-Instruct-v0.3
  --host 0.0.0.0
--port 8000| Outil | Meilleur usage | Niveau de simplicité | Point d’attention |
| Ollama | Démarrer vite, servir un modèle local, intégrer via API | Très simple | Moins fin pour les optimisations avancées |
| LM Studio | Tester visuellement plusieurs modèles et paramètres | Très simple | Moins adapté à une prod automatisée lourde |
| Llama.cpp | Contrôle fin, GGUF, quantification, machines modestes | Moyen | Configuration plus technique |
| VLLM | Débit élevé, batchs, concurrence, GPU serveur | Moyen à avancé | Demande un environnement GPU solide |
Comment brancher le SLM dans VS Code ?
Je branche rarement un SLM directement dans VS Code comme un simple chat posé à côté du code. Ça dépanne, oui, mais ça reste limité. Ce qui devient vraiment productif, c’est une interface agentique comme Cline, parce qu’elle travaille dans le dépôt, lit les fichiers, propose un plan, modifie le code et peut lancer des commandes dans le terminal sous mon contrôle.
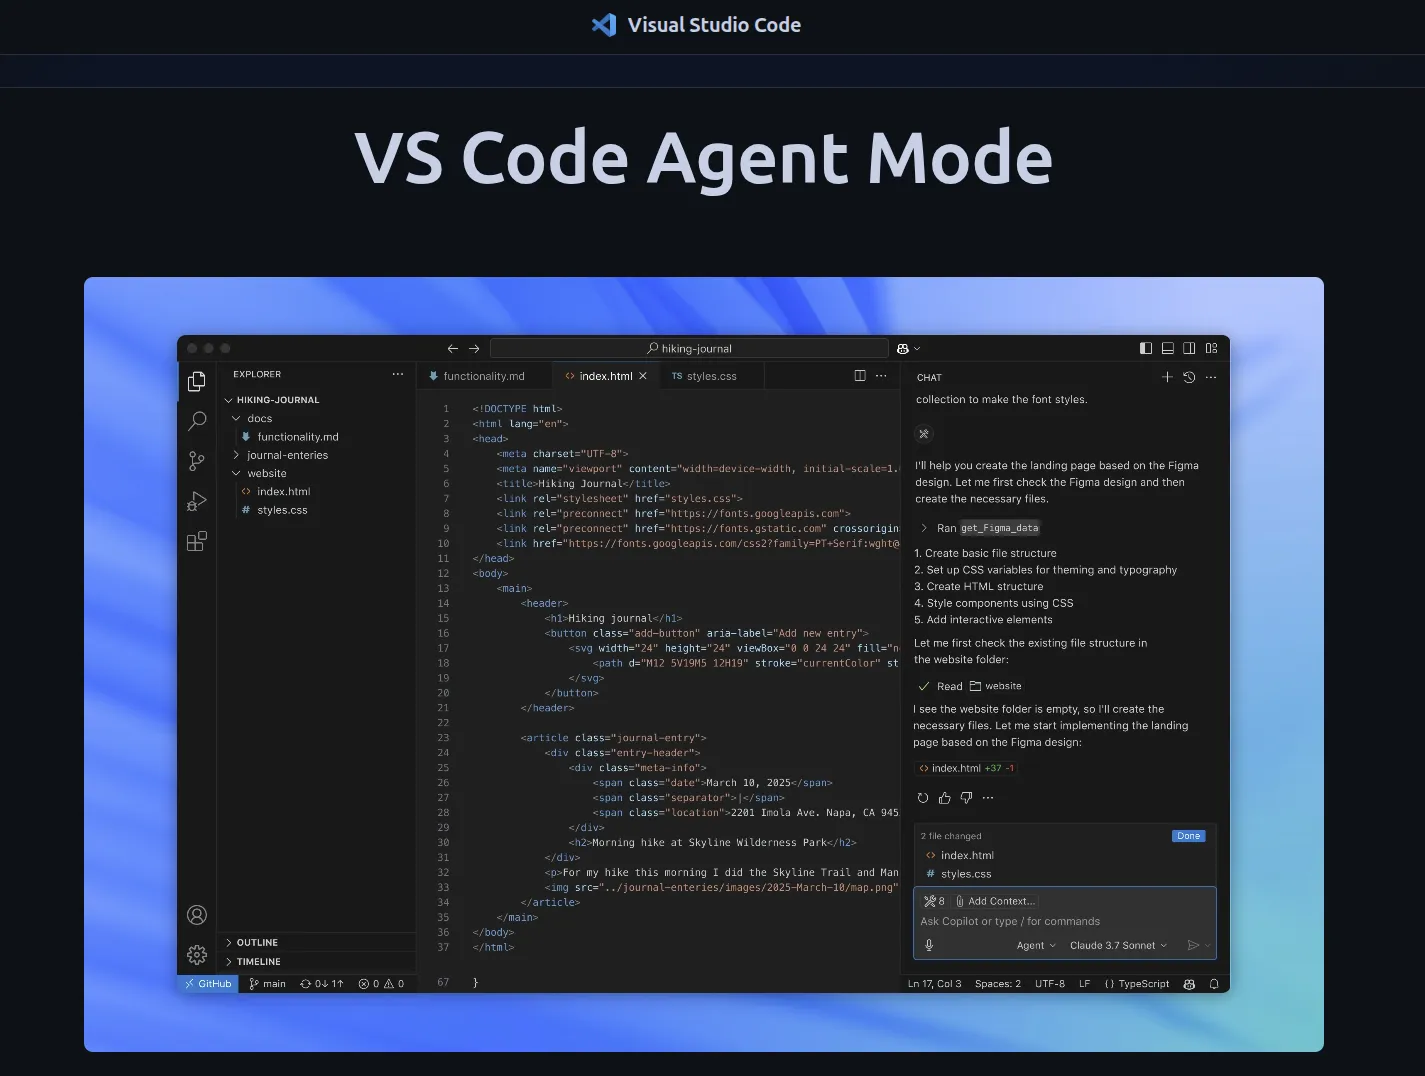
Cline change la logique. Je ne lui demande pas juste “Corrige ce bug”. Je lui donne une tâche, un périmètre, des contraintes. Il inspecte le projet, comprend les dépendances, ouvre les fichiers utiles, puis avance étape par étape. Avec un petit modèle local, c’est important. Le SLM n’a pas besoin d’être génial partout, il doit surtout être bien cadré.
| Simple chat | Je copie-colle du code, il répond hors contexte. |
| Cline | Il lit le dépôt, propose un plan, modifie les fichiers et lance les tests. |
| MCP | Il sert de passerelle propre entre l’agent et des outils externes, comme une base, une API interne ou une doc métier. |
Le workflow réaliste ressemble à ça. Je demande un refactor sur un module précis. Cline inspecte les fichiers concernés, me propose un plan avant modification, applique les changements, lance les tests, tombe sur une erreur, corrige, relance, puis me demande validation. Là, je garde la main. C’est exactement ce que je veux. Pas un stagiaire magique. Un assistant rapide, mais surveillé.
Les prompts doivent être très concrets. Voilà ceux que j’utilise souvent dans Cline.
Analyse le module de facturation.
Propose un plan avant toute modification.
Ne modifie aucun fichier de configuration.
Ne touche pas aux migrations.
Attends ma validation avant d'écrire du code.
Refactorise uniquement le dossier src/services/payment.
Garde le comportement actuel.
Ajoute ou adapte les tests si nécessaire.
Lance les tests après changement.
Si un test échoue, explique l'erreur avant de corriger.Inspecte ce bug sans modifier les fichiers.
Identifie les causes probables.
Liste les fichiers impliqués.
Propose la correction la plus petite possible.Il y a quand même des compromis. Je relis toujours. Je limite les permissions terminal. Je découpe les demandes. Je ne donne pas “Refais l’architecture” à un petit modèle local, sinon il part dans tous les sens. J’ai vu ça chez un client sur un vieux projet Node, le modèle était correct, mais le contexte était sale. Résultat moyen. Après avoir isolé trois fichiers et ajouté une consigne claire, il est devenu utile.
Ma règle terrain est simple. Plus le contexte est propre, plus le petit modèle est utile.
Comment garder un SLM fiable ?
Je garde un SLM fiable en le traitant comme un collègue junior très rapide, pas comme une source de vérité. Il peut aller vite, proposer du code utile, résumer un fichier, écrire des tests, mais il peut aussi inventer une API, rater un cas limite ou modifier trois fichiers de trop sans prévenir.
Les petits modèles ont des limites normales. Ils raisonnent moins bien qu’un grand modèle, ils sont plus sensibles au prompt, leur contexte est plus court, et sur le code ils peuvent produire quelque chose de plausible mais faux. Je l’ai vu chez un client sur une migration React toute simple : le modèle avait “corrigé” un composant, mais il avait cassé un comportement métier caché dans un hook. Rien de dramatique, parce qu’on avait les tests.
La fiabilité vient surtout de la pile autour du modèle. Je verrouille avec du lint, du typage, des tests automatisés, des commandes terminal contrôlées, des petits tickets, des prompts courts, et des fichiers ciblés. Je lui donne rarement “améliore le projet”. Je préfère “dans ce fichier, corrige cette fonction, sans toucher au reste”. C’est moins magique, mais beaucoup plus fiable.
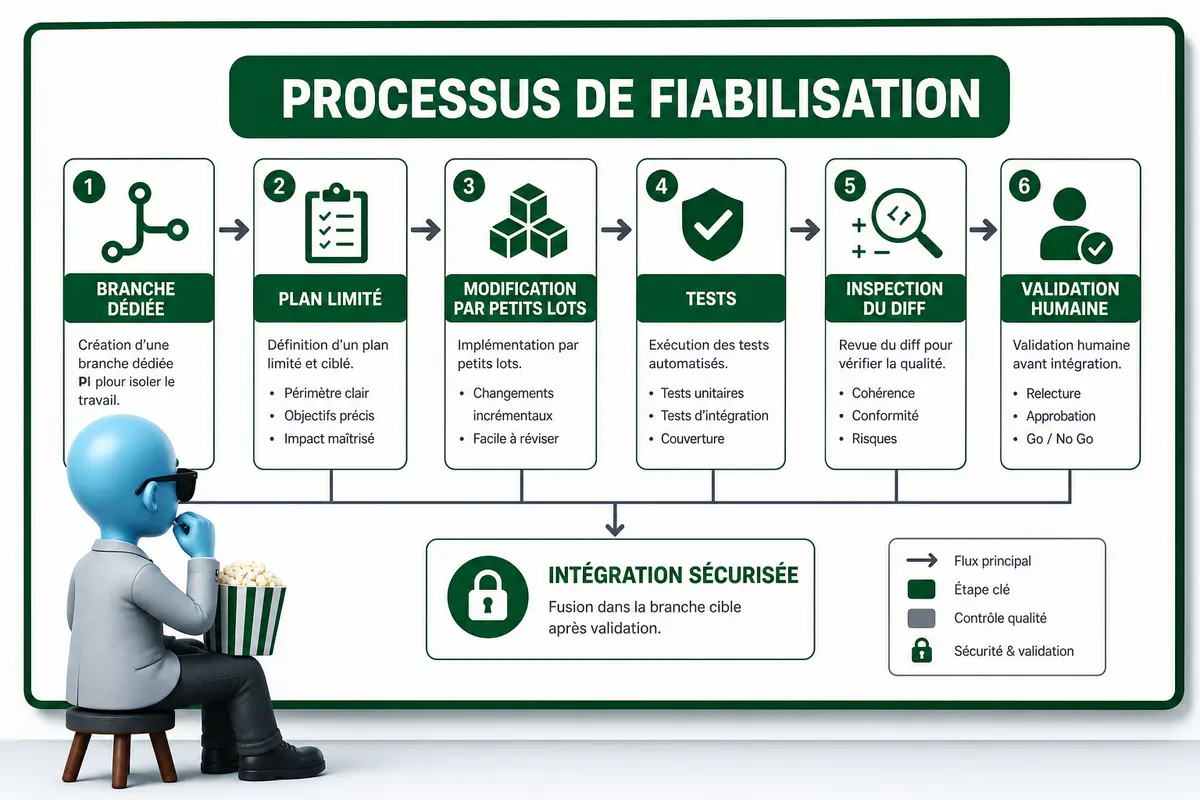
Pour sécuriser un workflow local, je commence toujours dans une branche dédiée. Ça évite de salir le travail en cours.
git checkout -b fix/slm-small-changeEnsuite, je demande un plan avant le code. Si le plan touche trop de fichiers, je refuse. Je veux des changements par petits lots. Après chaque lot, je lance les tests adaptés au projet.
npm test
pytest
Puis j’inspecte le diff. C’est là que je vois si le modèle a vraiment suivi la consigne ou s’il a “pris des initiatives”.
git diff
git status
Si le diff est trop large, je coupe net. Je demande une version plus petite, ou je reviens en arrière. Un bon SLM doit rester dans son couloir.
Le choix du modèle dépend aussi de l’usage. Pour le code, je prends un modèle spécialisé code. Pour le résumé ou la documentation, un modèle instruct général suffit souvent. Pour l’extraction de données, je privilégie un modèle stable avec une sortie JSON propre. Pour l’assistance terminal, je veux un modèle prudent, capable d’expliquer la commande avant de l’exécuter. Le terminal, ce n’est pas un terrain de jeu.
| Problème fréquent | Cause probable | Correction simple |
| Le modèle modifie trop de fichiers | Prompt trop large | Limiter à un fichier et une tâche précise |
| Le code compile mais casse le métier | Manque de contexte fonctionnel | Ajouter tests métier et validation humaine |
| Le modèle invente une API | Connaissance incomplète | Fournir la doc locale ou le fichier source |
| Les réponses changent trop | Prompt instable ou trop long | Réduire le prompt et fixer le format attendu |
| Les bugs passent en revue | Pas assez de garde-fous | Lancer lint, typage, tests et inspecter git diff |
Vous commencez par quelle couche ?
Un SLM local devient vraiment utile quand je l’installe dans une pile cohérente. Le moteur sert le modèle, l’éditeur lui donne accès au projet, les outils comme MCP ouvrent le workflow, les tests gardent le contrôle. Pour démarrer, je choisirais souvent Ollama, puis Cline dans VS Code, avec des tâches courtes et vérifiables. Si vous avez besoin de comparer des modèles, LM Studio aide bien. Si vous cherchez le contrôle bas niveau, llama.cpp reste solide. Si vous avez du volume, vLLM prend le relais. Le bénéfice pour vous est simple : un assistant local plus rapide, plus privé, et réellement intégré à votre façon de développer.
FAQ
- Qu’est-ce qu’un local AI stack pour SLM ?
C’est l’ensemble des outils qui permettent d’utiliser un petit modèle de langage en local dans un vrai workflow. Il y a le moteur qui sert le modèle, l’interface de travail, les connexions aux outils, puis les garde-fous comme les tests et la validation humaine. - Ollama suffit-il pour travailler avec un modèle local ?
Ollama suffit pour démarrer vite, lancer un modèle et l’exposer via une API locale. Pour être productif dans le développement, il faut souvent ajouter une interface comme Cline dans VS Code, puis structurer les tâches, les tests et les validations. - Quelle différence entre Ollama, LM Studio, llama.cpp et vLLM ?
Ollama est simple et pratique pour la plupart des développeurs. LM Studio aide à tester visuellement plusieurs modèles. llama.cpp donne plus de contrôle, notamment avec GGUF et la quantification. vLLM vise plutôt les usages à fort débit avec requêtes concurrentes. - Cline peut-il modifier mon code tout seul ?
Cline peut proposer un plan, modifier des fichiers et exécuter des commandes terminal dans VS Code. Je conseille de le garder sous contrôle : demander un plan avant action, travailler par petits lots, relire les diffs et lancer les tests après chaque changement. - Un SLM local peut-il remplacer un grand modèle cloud ?
Pas toujours. Un SLM local est très utile pour des tâches ciblées, du code courant, de la documentation, du résumé ou de l’automatisation locale. Pour du raisonnement complexe ou des contextes très larges, un grand modèle peut rester meilleur. Le bon choix dépend du cas d’usage.
A propos de l’auteur
Je suis Franck Scandolera, responsable de l’agence webAnalyste et de Formations Analytics. J’accompagne des équipes sur le tracking server-side, l’Analytics Engineering, l’automatisation No/Low Code avec n8n, l’intégration de l’IA en entreprise et le SEO/GEO. J’ai travaillé avec des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez mettre en place une stack IA locale, propre, utile et adaptée à votre business, je peux vous aider. Contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.