
Les agents IA Snowflake deviennent fiables quand ils s’appuient sur une couche sémantique gouvernée, pas sur des définitions bricolées au fil de l’eau. Je vais montrer comment cadrer les métriques, éviter les doublons, certifier les vues sémantiques et donner à Cortex Analyst des réponses cohérentes.
Pourquoi les agents IA décrochent-ils ?
Les agents IA décrochent surtout quand on sacrifie la gouvernance pour aller vite, quand plusieurs définitions business cohabitent pour la même métrique, et quand les réponses ne sont pas déterministes.
Je le vois souvent avec des équipes qui veulent mettre un agent Snowflake en production rapidement. Sur le papier, ça marche. L’agent répond, il interroge les données, il donne une synthèse. Mais si personne ne sait quelle définition du revenu, du client actif ou du churn il utilise, la valeur devient très fragile.
Le problème n’est pas vraiment le LLM. Le LLM, c’est le moteur de langage, celui qui comprend la question et formule la réponse. Le vrai sujet, c’est la base de connaissance opérationnelle qu’on lui donne. Si cette base contient des règles floues, des tables redondantes, des métriques non validées ou des filtres implicites, l’agent va juste rendre le flou plus rapide.
Le premier décrochage vient des raccourcis de gouvernance. On branche l’agent sur des données disponibles, pas forcément sur des données validées. C’est tentant, surtout quand le sponsor veut une démo pour vendredi. Mais en production, la démo devient un outil utilisé par des équipes qui prennent de vraies décisions.
Le deuxième décrochage vient de la duplication. Deux agents peuvent répondre à la même question avec deux logiques différentes. Deux équipes peuvent aussi avoir chacune leur définition du revenu mensuel. J’ai déjà vu des équipes obtenir trois réponses différentes sur le chiffre d’affaires mensuel parce que chaque équipe avait sa propre logique de filtre, de période et d’agrégation. Ce genre d’écart détruit vite la confiance des métiers.
Le troisième décrochage vient de l’absence de réponses reproductibles. Une réponse déterministe, ça veut dire qu’à question identique, contexte identique et données identiques, on obtient la même réponse. Si l’agent change de logique selon la formulation de la question, l’utilisateur ne sait plus s’il consulte un outil fiable ou une boîte noire sympa.
| Cause du problème | Gouvernance contournée, définitions métiers dupliquées, règles de calcul non centralisées. |
| Symptôme côté utilisateur | L’agent donne des réponses différentes pour une même métrique selon la question, l’équipe ou le contexte. |
| Risque business | Les métiers perdent confiance, les décisions se contredisent, et l’agent finit contourné au lieu d’être adopté. |
À quoi sert une couche sémantique ?
Une couche sémantique sert à transformer des tables brutes en définitions business stables et réutilisables. Pour moi, c’est une sorte de contrat propre entre votre entrepôt Snowflake et ceux qui consomment la donnée, humains comme agents IA.
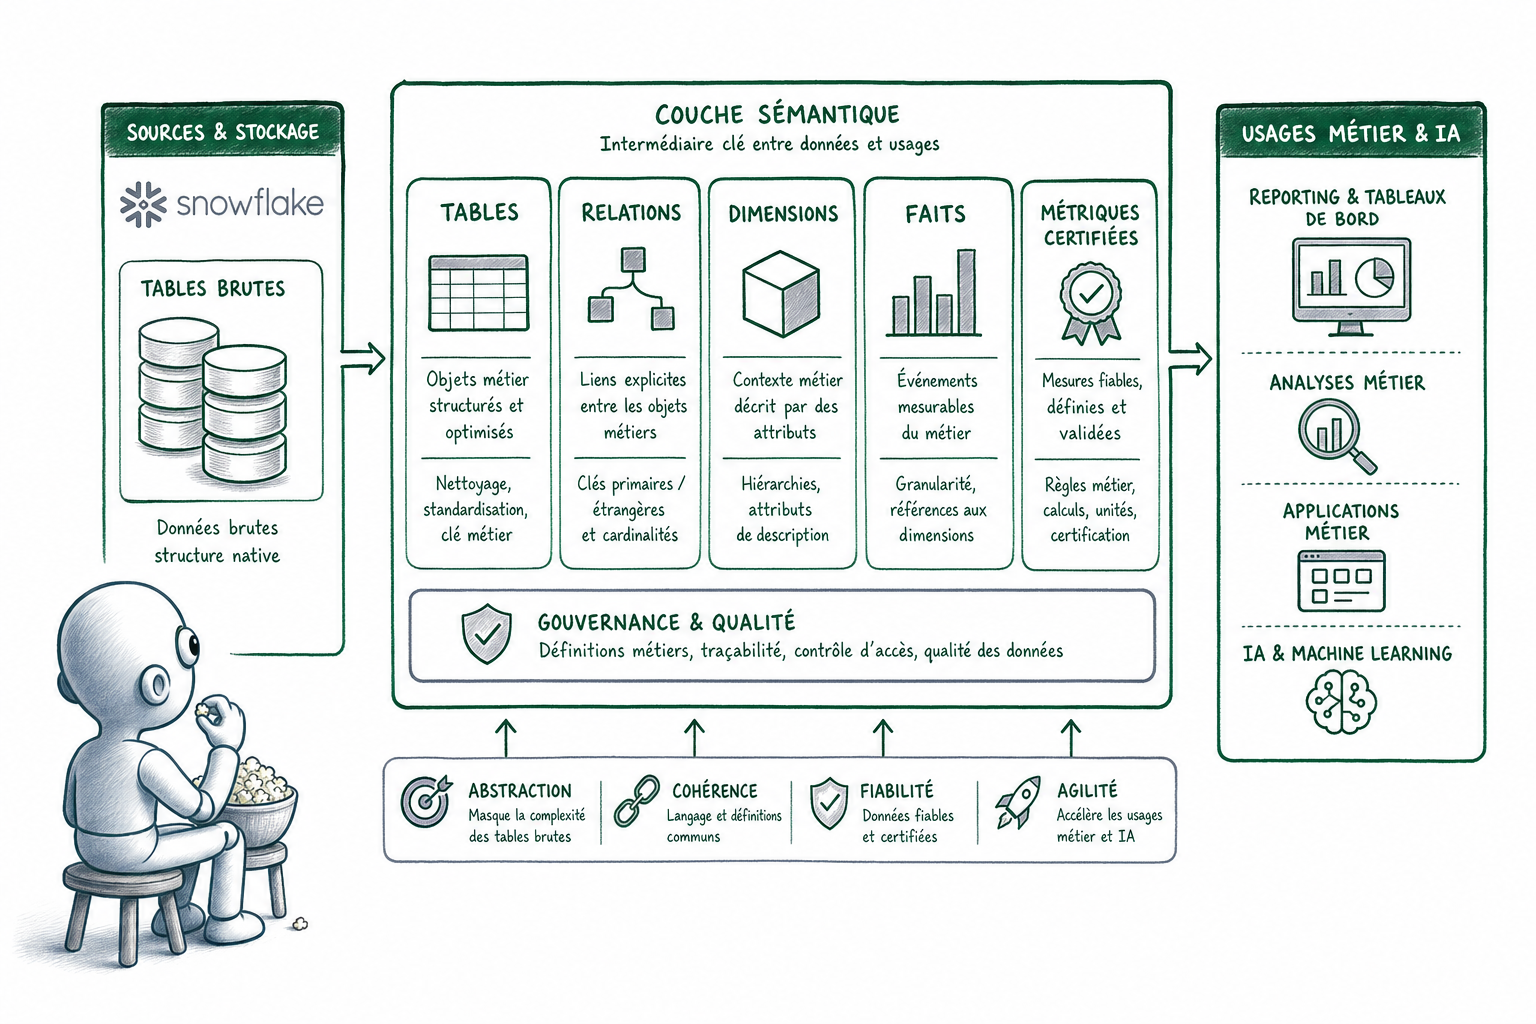
Elle se place entre les tables techniques et les usages. Elle dit clairement quelles tables sont autorisées, quelles dimensions existent, quels faits sont disponibles, quelles métriques sont certifiées, quels filtres appliquer, quelles agrégations utiliser, et à quelle granularité on parle. La granularité, c’est le niveau de détail. Une facture, un client, un abonnement, un mois. Ce n’est pas un détail, c’est souvent là que les erreurs commencent.
Concrètement, ça change beaucoup pour un agent IA. Au lieu de deviner comment calculer le revenu mensuel récurrent, il s’appuie sur une définition validée. Il ne réinvente pas une logique SQL à chaque question. Il utilise la même vérité que les analystes, les dashboards et les équipes métier. Ce n’est pas magique, ça ne rend pas une mauvaise donnée parfaite, mais ça évite déjà une grosse partie des réponses incohérentes.
Dans une base SaaS de facturation, une dimension, c’est un angle d’analyse. Par exemple le client, le statut du client, le plan d’abonnement, ou la date de facture. Un fait, c’est un événement ou une ligne mesurable, comme une facture émise, un abonnement actif, un paiement reçu. Une métrique, c’est un calcul métier posé dessus, comme le montant facturé, le revenu mensuel récurrent, ou le nombre de clients actifs.
J’ai vu ce problème chez un client avec trois équipes qui calculaient le MRR différemment. L’agent IA répondait parfois juste, parfois faux, surtout parce qu’il héritait de cette confusion. La couche sémantique n’a pas réglé toute l’organisation, mais elle a fixé une définition commune. Et ça, pour un agent, c’est énorme.
| Approche | Avantage | Limite | Impact sur les agents IA |
| Requêtes directes sur tables brutes | Accès flexible à toute la donnée | Logique métier dispersée, risque d’erreur élevé | L’agent devine les jointures, les filtres et les calculs |
| Accès via couche sémantique | Définitions métier stables et réutilisables | Demande un vrai travail de modélisation au départ | L’agent s’appuie sur des métriques certifiées et cohérentes |
Où placer ça dans Snowflake ?
Dans Snowflake, je place cette logique dans des semantic views consommées par Cortex Analyst, puis orchestrées dans des parcours agentiques avec Cortex Agents. L’intérêt est simple : la donnée, les définitions métier et les usages IA restent dans le même environnement. On évite les copies, les fichiers de règles qui traînent ailleurs, et les interprétations parallèles du genre “le chiffre du revenu dépend de qui le demande”.
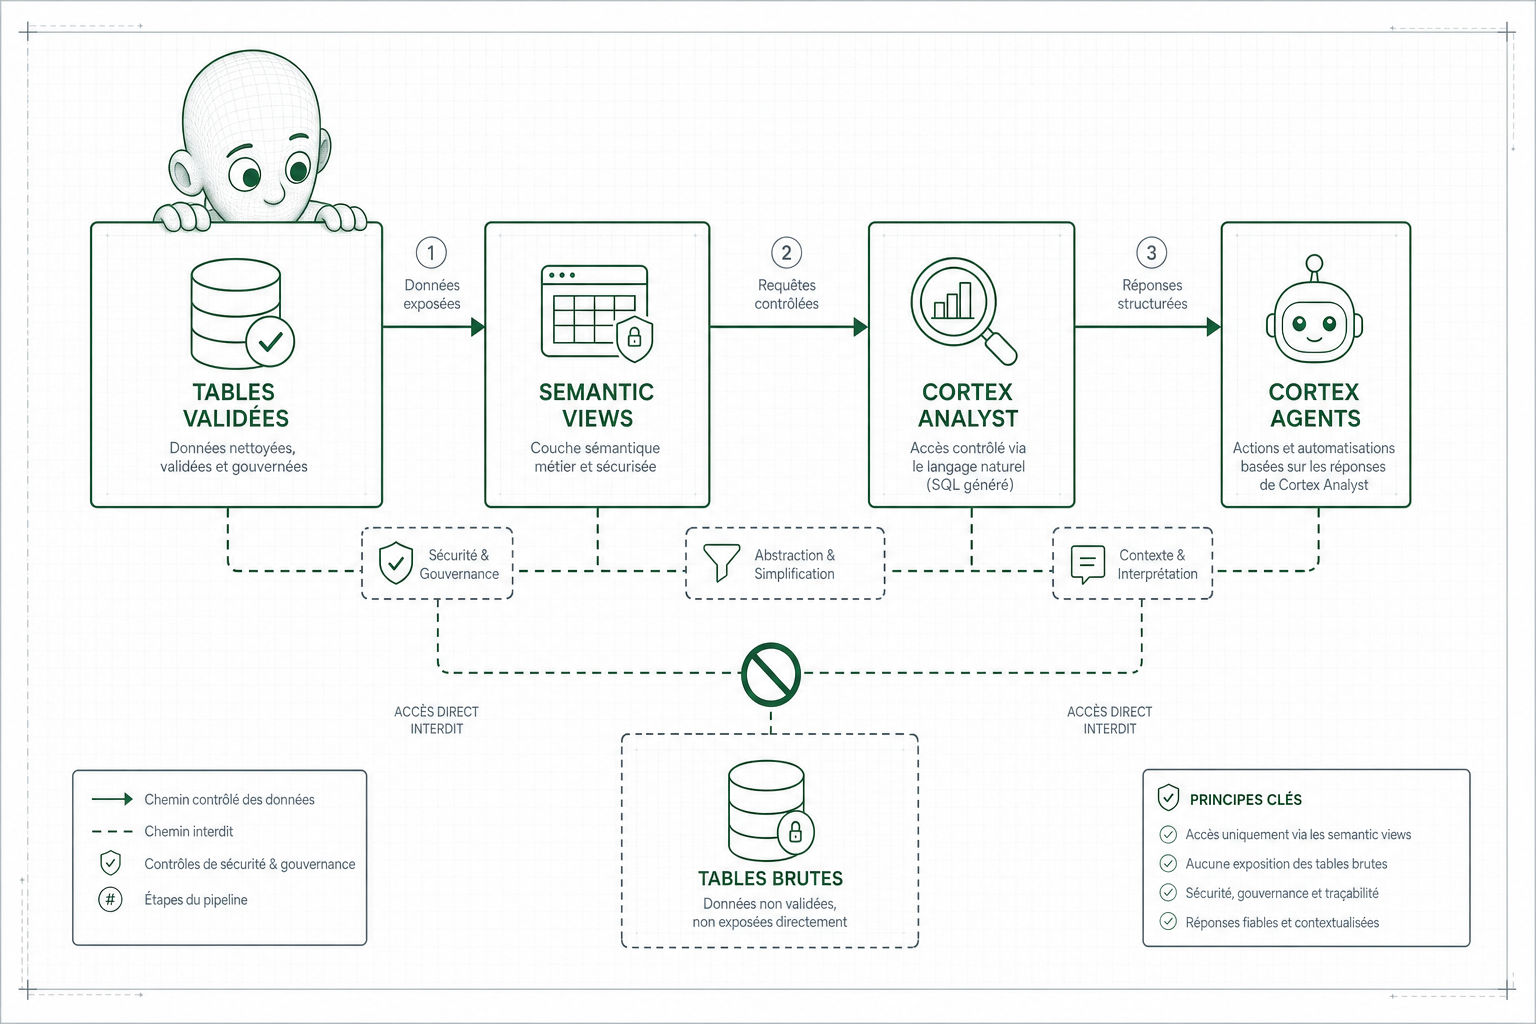
Cortex Analyst sert d’interface de question-réponse sur des données structurées, à partir d’un modèle sémantique. Cortex Agents sert plutôt à orchestrer plusieurs outils ou services Cortex, dont cette analyse structurée. Je reste prudent avec ça : le vrai sujet, ce n’est pas de rendre l’agent “magique”. C’est de l’obliger à interroger des définitions gouvernées, pas des tables en direct.
Voici un exemple de facturation SaaS. C’est un exemple à adapter à la syntaxe Snowflake en vigueur dans votre compte.
-- Exemple à adapter à la syntaxe Snowflake en vigueur.
CREATE OR REPLACE SEMANTIC VIEW billing_saas_semantic_view

-- Je déclare uniquement les tables validées pour l’analyse IA.
TABLES (
  invoices PRIMARY KEY (invoice_id), -- Une facture reste l’unité de base.
  customers PRIMARY KEY (customer_id), -- Le client est identifié sans ambiguïté.
  subscriptions PRIMARY KEY (subscription_id) -- L’abonnement porte le statut commercial.
)

-- Je rends les jointures explicites pour éviter les rapprochements inventés.
RELATIONSHIPS (
  invoices.customer_id REFERENCES customers(customer_id),
  invoices.subscription_id REFERENCES subscriptions(subscription_id)
)

-- Je définis les axes métier autorisés pour les questions.
DIMENSIONS (
  customers.customer_segment AS customer_segment COMMENT 'Segment commercial du client',
  DATE_TRUNC('MONTH', invoices.invoice_date) AS invoice_month COMMENT 'Mois de facturation',
  subscriptions.status AS subscription_status COMMENT 'Statut courant de l’abonnement'
)

-- Je fixe les faits numériques disponibles au bon grain.
FACTS (
  invoices.amount AS invoice_amount COMMENT 'Montant facturé sur une ligne de facture'
)

-- Je nomme les métriques que l’agent peut utiliser dans ses réponses.
METRICS (
  total_billed AS SUM(invoice_amount) COMMENT 'Montant total facturé, métrique certifiée',
  active_customers AS COUNT(DISTINCT CASE WHEN subscription_status = 'ACTIVE' THEN customers.customer_id END) COMMENT 'Clients actifs, métrique certifiée',
  average_invoice_amount AS AVG(invoice_amount) COMMENT 'Montant moyen de facture, métrique certifiée'
);
Chaque bloc réduit un risque. Les tables contrôlées limitent le périmètre. Les relations explicites évitent les jointures hasardeuses. La granularité stabilisée empêche de mélanger facture, client et abonnement n’importe comment. Les métriques nommées donnent un vocabulaire commun à l’agent, à l’analyste et au métier. Les descriptions métier aident Cortex Analyst à choisir le bon sens quand une question est ambiguë.
Je ne laisse jamais une métrique critique sans propriétaire métier et sans règle de revue.
Comment certifier sans ralentir ?
On certifie sans ralentir en standardisant le cycle de vie des définitions sémantiques, pas en ajoutant des comités partout. Je garde un flux simple : brouillon, revue data, revue métier, tests, version, promotion, monitoring. Ça encadre juste assez pour éviter le chaos, sans transformer chaque métrique en dossier administratif.
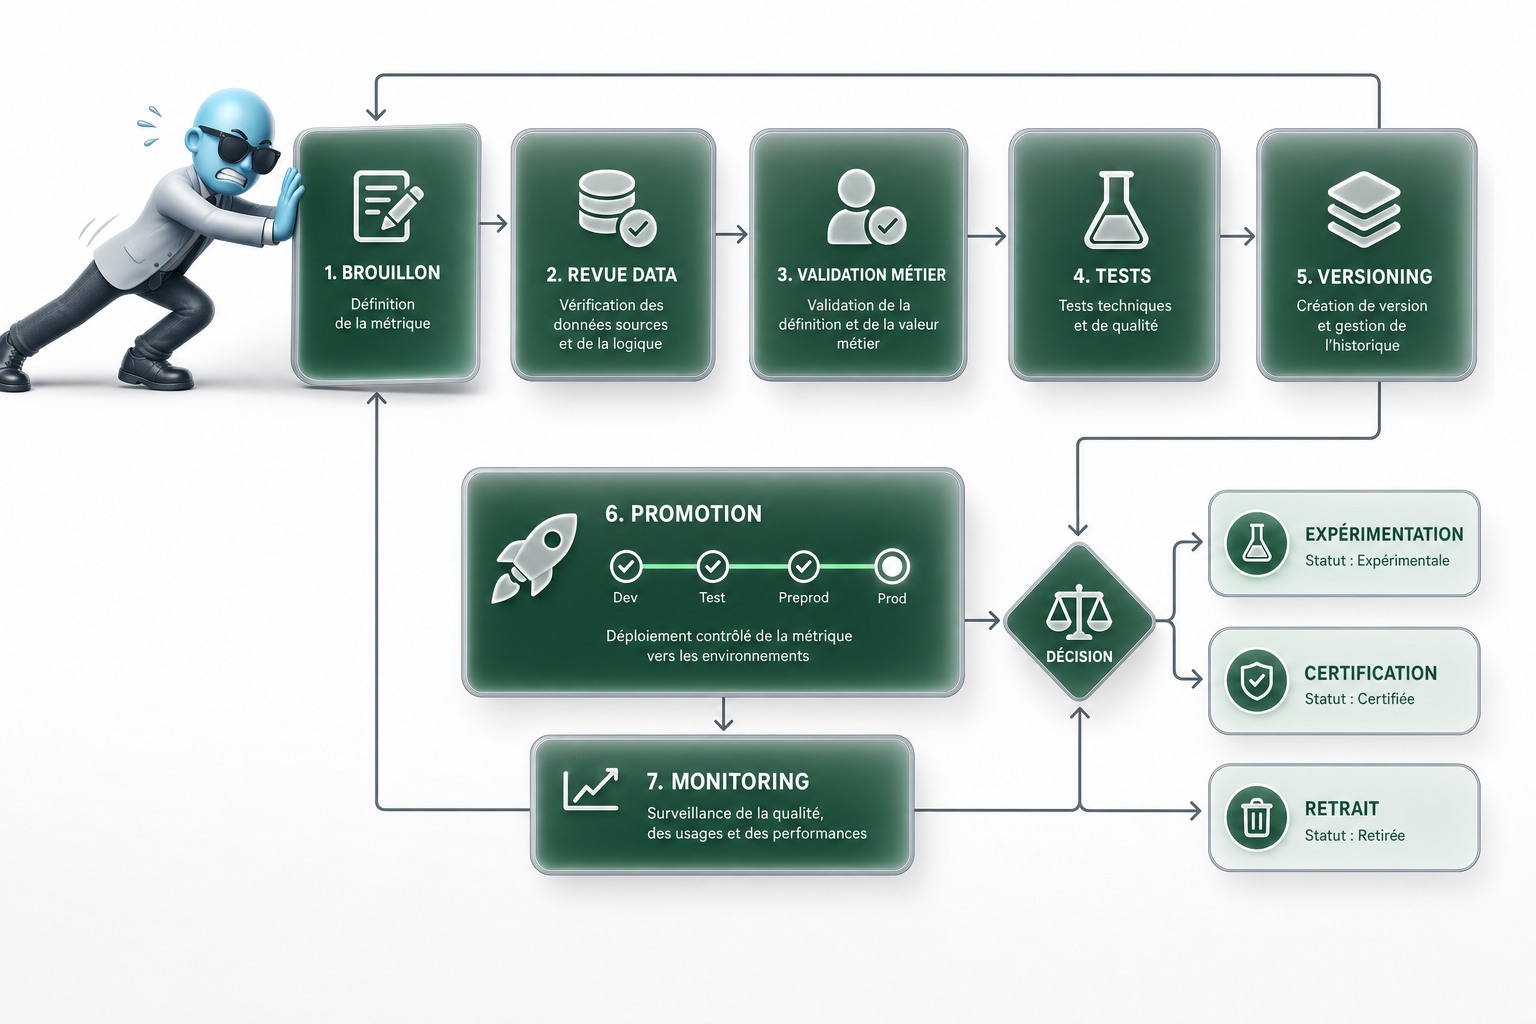
Dans Snowflake, une définition sémantique, c’est la façon officielle de décrire une métrique ou un objet métier pour qu’un agent IA comprenne quoi répondre. Par exemple “revenu net”, “client actif”, “marge commerciale”. Si chaque équipe crée son agent avec sa propre définition du revenu, on fabrique mécaniquement des réponses incohérentes. J’ai déjà vu ça chez un client : trois dashboards, trois revenus, trois réunions pour savoir lequel était “le vrai”. Le problème n’était pas l’IA. Le problème était la duplication.
Les rôles doivent être clairs. L’équipe data modélise et écrit la logique. Le métier valide le sens. Un owner arbitre les changements quand deux besoins se contredisent. L’équipe plateforme gère les droits, les environnements, le déploiement et la promotion entre dev, test et production.
Voici la checklist opérationnelle que j’utilise avant de certifier une définition :
- Nom métier clair.
- Description compréhensible par un non-technique.
- Propriétaire identifié.
- Formule explicite.
- Granularité précisée, par exemple client, commande, jour.
- Filtres appliqués.
- Exclusions connues.
- Tests attendus.
- Date de version.
- Statut de certification.
Les tests SQL servent à éviter les mauvaises surprises avant qu’un agent IA ne réponde avec assurance quelque chose de faux. Cette logique est simple à automatiser dans Snowflake, dans un job planifié ou dans votre pipeline de déploiement.
-- Vérifier les valeurs nulles sur les clés
SELECT COUNT(*) AS nb_null_keys
FROM analytics.fact_revenue
WHERE customer_id IS NULL OR order_id IS NULL;

-- Contrôler les doublons sur la granularité attendue
SELECT customer_id, order_id, COUNT(*) AS nb_rows
FROM analytics.fact_revenue
GROUP BY customer_id, order_id
HAVING COUNT(*) > 1;

-- Comparer une métrique certifiée avec une table de référence
SELECT
  SUM(revenue_net) AS revenue_certified,
  ref.revenue_expected
FROM analytics.fact_revenue f
CROSS JOIN reference.revenue_monthly_control ref
WHERE f.month = ref.month
GROUP BY ref.revenue_expected;

-- Vérifier qu’un changement de définition est documenté
SELECT COUNT(*) AS nb_missing_changelog
FROM governance.semantic_definitions
WHERE version_status = 'CHANGED'
AND changelog IS NULL;| Situation | Décision | Pourquoi |
| Usage limité, définition encore discutée, impact faible. | Laisser en expérimentation. | On apprend vite sans figer trop tôt. |
| Usage récurrent, owner identifié, tests OK, métier aligné. | Certifier. | On protège la confiance et on donne une source fiable aux agents IA. |
| Définition doublonnée, obsolète, non maintenue ou contradictoire. | Retirer. | On réduit le bruit et on évite les réponses incohérentes. |
Et si vos agents IA répondaient enfin avec la même vérité ?
Un agent IA Snowflake fiable ne vient pas d’un prompt plus malin. Il vient d’une donnée mieux cadrée. Si les définitions business changent selon les équipes, les agents produisent des réponses instables, même avec un bon modèle. La couche sémantique remet de l’ordre : tables contrôlées, métriques certifiées, granularité claire, cycle de revue et versioning. Snowflake, avec les semantic views, Cortex Analyst et Cortex Agents, donne un cadre intéressant pour industrialiser ça. Le vrai bénéfice pour vous : moins de débats sur les chiffres, plus de confiance dans les réponses, et des agents IA vraiment utilisables en production.
FAQ
- Pourquoi un agent IA Snowflake peut donner des réponses incohérentes ?
Parce qu’il interroge parfois des données ou des définitions métier qui ne sont pas gouvernées. Si le revenu, le churn ou le client actif sont calculés différemment selon les équipes, l’agent ne peut pas produire une réponse stable. Il amplifie surtout le désordre existant. - Qu’est-ce qu’une couche sémantique dans Snowflake ?
C’est une couche qui décrit les données dans un langage métier contrôlé : tables, relations, dimensions, faits, métriques et règles d’agrégation. Elle sert d’intermédiaire entre les tables brutes et les utilisateurs, y compris les agents IA. - Quel est le rôle de Cortex Analyst ?
Cortex Analyst permet de poser des questions en langage naturel sur des données structurées, en s’appuyant sur un modèle sémantique. L’intérêt est de guider l’analyse avec des définitions claires au lieu de laisser le modèle deviner la logique métier. - Pourquoi certifier les métriques avant de les donner à un agent IA ?
Une métrique certifiée a été revue, documentée et validée. Ça réduit les doublons, les écarts de calcul et les débats interminables sur les chiffres. Pour un agent IA, c’est essentiel : il peut répondre vite, mais surtout avec la bonne définition. - Comment éviter de ralentir les équipes avec la gouvernance ?
Il faut un workflow simple : brouillon, revue, tests, validation métier, versioning et promotion. Pas besoin de bureaucratie lourde. Le but est de garder la vitesse tout en empêchant les définitions critiques de partir dans tous les sens.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes data, marketing et produit sur des sujets où la qualité de la donnée conditionne directement la performance business. Avec webAnalyste et Formations Analytics, j’ai travaillé pour des organisations comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez cadrer vos agents IA, votre gouvernance data ou vos automatisations, contactez-moi, je peux vous aider.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.