
Le Recursive Self-Improvement peut changer l’IA si un système arrive à garder ses gains, les réutiliser, puis améliorer sa propre façon de s’améliorer. On n’y est pas encore. Mais des briques existent déjà, surtout côté agents, code, entraînement et workflows automatisés.
C’est quoi le Recursive Self-Improvement ?
Le Recursive Self-Improvement, ou RSI, c’est une IA qui utilise ses propres améliorations pour produire d’autres améliorations, de manière répétée.
Dit comme ça, ça paraît simple. Mais la nuance est importante. Une optimisation classique, c’est quand on améliore un système depuis l’extérieur. Un humain ajuste un prompt, change un modèle, ajoute un outil, corrige une règle métier. Le système devient meilleur, oui, mais il n’est pas vraiment l’auteur de son progrès.
Une vraie auto-amélioration récursive commence quand l’IA garde un gain utile, puis s’en sert plus tard pour aller chercher un nouveau gain. Le mot clé, pour moi, c’est durablement. Produire une meilleure réponse une fois, ce n’est pas du RSI. C’est juste une bonne réponse, ou une correction locale.
Par exemple, si un modèle écrit une mauvaise réponse, puis se relit et corrige son texte, je ne parlerais pas encore de RSI. Il a amélioré une sortie, pas forcément lui-même. Par contre, si un agent observe qu’il fait souvent la même erreur, modifie son workflow, ajoute une vérification automatique, enrichit sa mémoire, choisit un meilleur outil pour les prochaines tâches, là on commence à toucher au sujet.
J’ai vu ça chez un client sur des agents d’analyse documentaire. Le premier niveau, c’était juste “réponds mieux”. Pas très intéressant. Le vrai saut est arrivé quand l’agent a commencé à mémoriser quels contrôles évitaient les erreurs, puis à les réutiliser sur les dossiers suivants. Ce n’était pas une explosion d’intelligence, loin de là, mais on passait d’une réponse améliorée à un processus amélioré.
L’idée n’est pas nouvelle. Dans les années 60, I.J. Good parlait déjà d’une “explosion d’intelligence” : une machine assez intelligente pourrait concevoir une machine encore plus intelligente, qui ferait pareil à son tour. Pas besoin de dramatiser pour prendre ça au sérieux. Les systèmes modernes rendent juste la question plus concrète, parce qu’ils savent déjà écrire du code, utiliser des outils, planifier des tâches et accumuler du contexte.
| Situation | Est-ce du RSI | Pourquoi |
| Un modèle corrige une réponse avant de l’envoyer. | Non, pas forcément. | Le gain reste local à cette réponse. |
| Un humain améliore le prompt du système. | Non. | L’amélioration vient de l’extérieur. |
| Un agent ajoute une étape de vérification à son workflow et la réutilise ensuite. | Oui, potentiellement. | Le système conserve un gain et s’en sert pour progresser. |
| Un agent choisit de nouveaux outils pour mieux résoudre ses prochaines tâches. | Oui, si le changement dure. | L’amélioration devient une capacité réutilisable. |
Quels sont les niveaux du RSI ?
Les niveaux du RSI vont d’une amélioration locale sans mémoire jusqu’à un système capable d’améliorer son propre processus d’amélioration. C’est ça l’échelle utile. Pas juste “l’IA devient meilleure”, mais “est-ce qu’elle garde quelque chose de cette amélioration, et est-ce qu’elle s’en sert pour faire mieux la prochaine fois ?”.
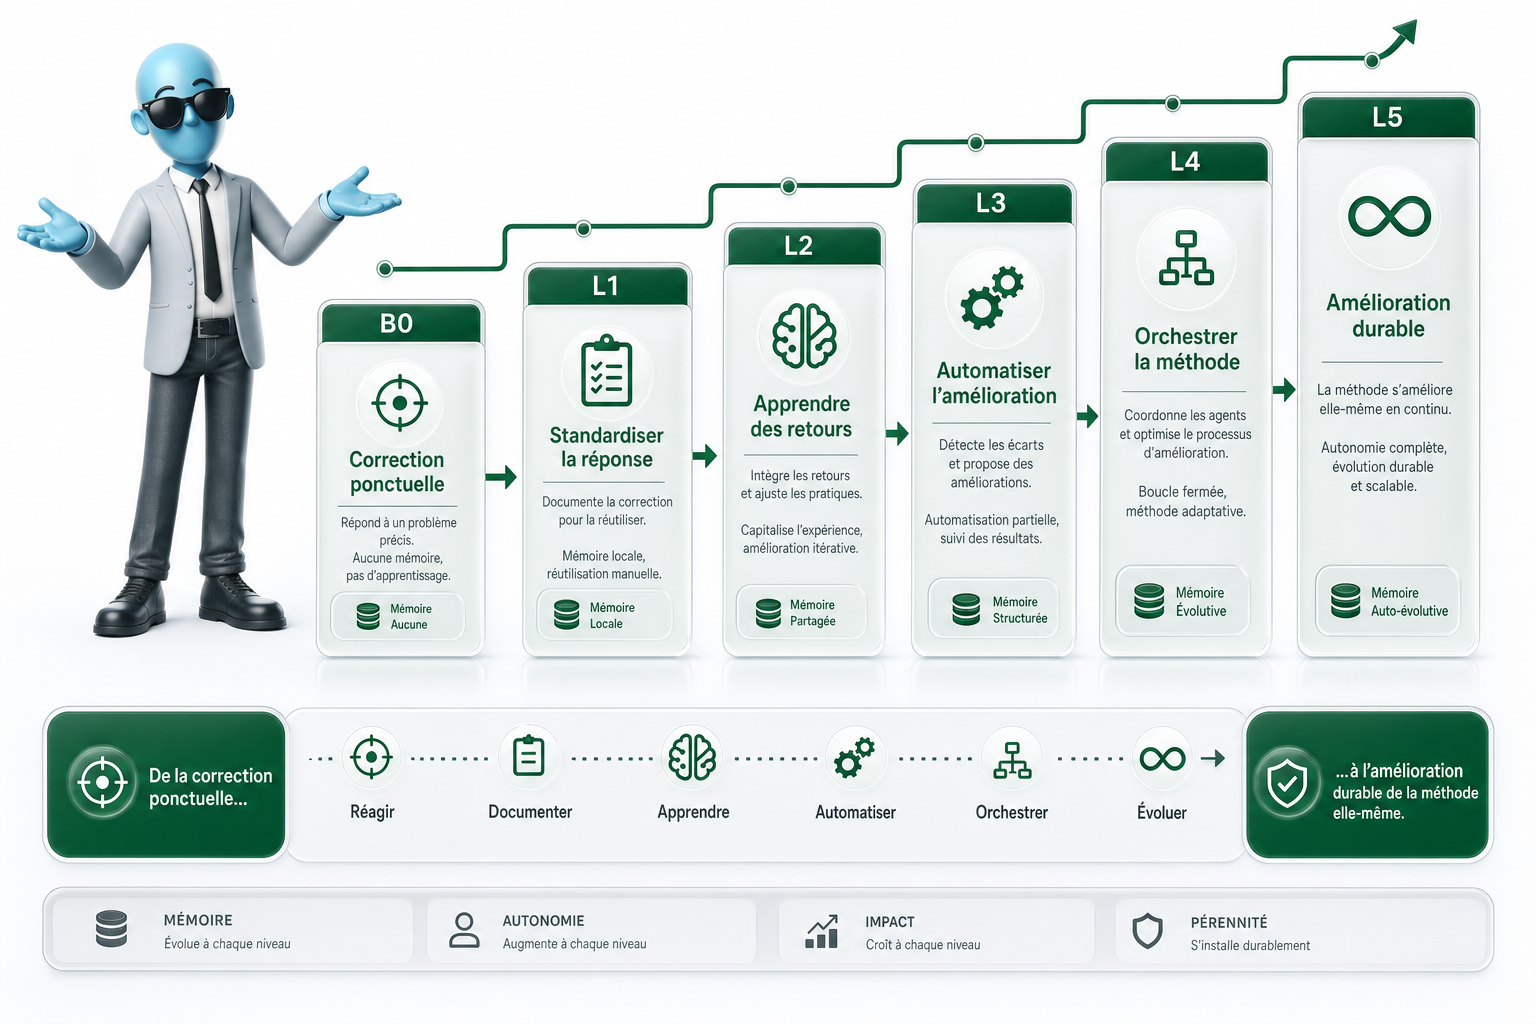
Au niveau B0, on a une amélioration ponctuelle. Le système produit une meilleure réponse, corrige un bug, optimise un bout de code, mais rien ne se transfère durablement. C’est mieux une fois. Puis on repart presque de zéro. Beaucoup de démos impressionnantes sont là, en réalité.
Avec L1, le système suit une recette donnée par un humain. Je lui dis quoi tester, comment mesurer, quoi modifier. Il exécute. C’est déjà utile, mais l’intelligence de l’amélioration reste surtout dans le protocole humain.
À L2, il choisit une stratégie dans un cadre fixé. Par exemple, il peut décider entre simplifier un prompt, changer un paramètre, relancer un test, comparer deux versions. Mais les règles du jeu restent définies par nous.
L3 devient plus intéressant. Le système apprend de ses erreurs pour guider ses essais suivants. Il ne tente pas juste des variantes au hasard. Il observe ce qui échoue, ce qui marche, et ajuste sa trajectoire. Là, on commence à sentir une boucle d’amélioration.
La vraie frontière, pour moi, arrive avec L4. Le système capitalise. Il garde les améliorations utiles dans sa mémoire, ses outils, ses prompts, son workflow ou son code. Il ne fait pas seulement mieux une fois, il devient mieux équipé pour refaire mieux demain.
L5, c’est le niveau le plus dur. Le système améliore la méthode qui sert à s’améliorer. Il ne change plus seulement une réponse ou un outil, il remet en question son propre cycle d’apprentissage, ses critères d’évaluation, ses stratégies de recherche. Là, on parle vraiment de Recursive Self-Improvement au sens fort.
Observation honnête : beaucoup de démonstrations actuelles ressemblent à du RSI vu de loin. Mais quand on regarde de près, les objectifs, les évaluations et le déploiement restent très encadrés par les humains. Ce n’est pas rien, mais ce n’est pas encore une autonomie complète.
| Niveau | Description courte | Autonomie |
| B0 | Amélioration ponctuelle sans transfert durable | Très faible |
| L1 | Suit une recette humaine pour s’améliorer | Faible |
| L2 | Choisit une stratégie dans un cadre fixé | Limitée |
| L3 | Apprend de ses erreurs pour orienter ses essais | Moyenne |
| L4 | Conserve les améliorations dans sa mémoire, ses outils ou son workflow | Élevée |
| L5 | Améliore sa propre méthode d’amélioration | Très élevée |
Qu’est-ce qui existe déjà aujourd’hui ?
Aujourd’hui, on automatise déjà des morceaux du cycle d’amélioration, mais on n’a pas encore un RSI complet et autonome. RSI, pour Recursive Self-Improvement, veut dire qu’une IA serait capable de s’améliorer elle-même, en boucle, sans dépendre fortement d’humains pour choisir les objectifs, modifier le système, tester, valider et déployer.
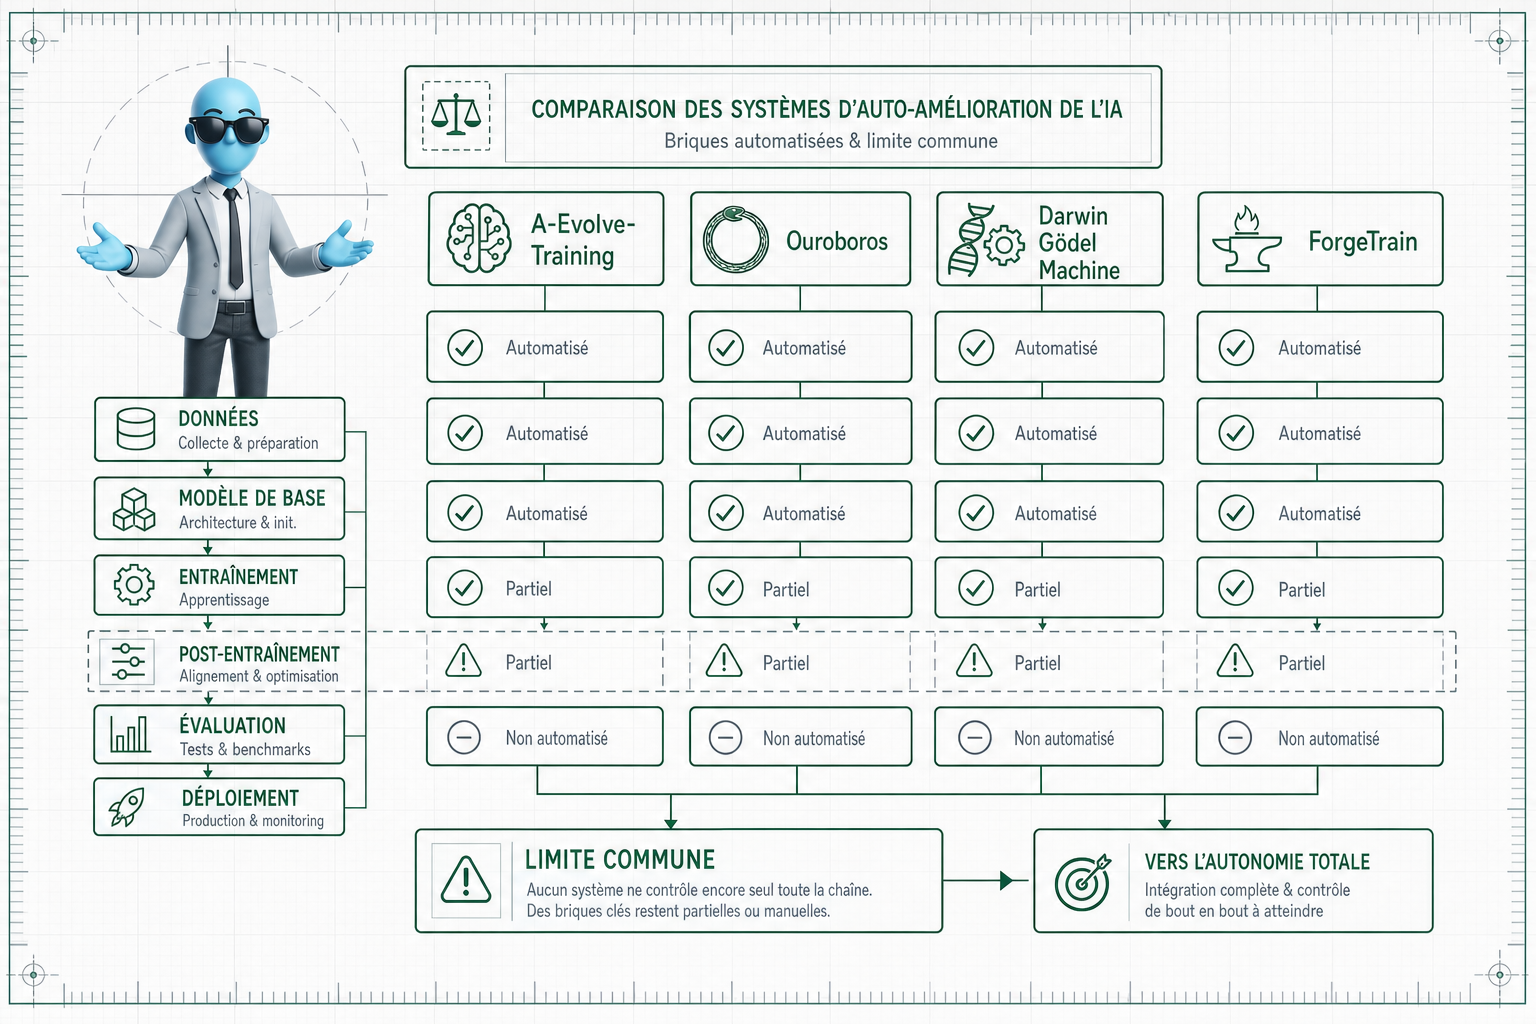
Ce qu’on voit dans les travaux récents, c’est plus nuancé. A-Evolve-Training, par exemple, ressemble à une approche qui automatise plusieurs tours de post-entraînement. Le post-entraînement, c’est la phase après le pré-entraînement d’un modèle, quand on l’ajuste pour qu’il suive mieux des consignes, raisonne mieux, ou se comporte de façon plus utile. C’est intéressant, parce qu’on commence à automatiser des boucles d’essai, d’évaluation et d’amélioration.
Ouroboros, lui, est présenté comme un agent de code capable de modifier certains éléments de son propre fonctionnement via ses outils et ses prompts. Un prompt, c’est simplement l’instruction donnée au modèle. Là aussi, c’est une forme d’auto-modification, mais dans un cadre limité. L’agent ne redéfinit pas toute son architecture, son infrastructure, ses métriques métier et sa mise en production tout seul.
Darwin Gödel Machine va dans une direction assez parlante. Le système améliore ses performances sur SWE-bench, un benchmark connu pour tester la capacité à résoudre de vrais problèmes logiciels issus de dépôts GitHub. C’est solide comme signal, parce qu’on parle de tâches de développement réalistes, pas juste de petits puzzles artificiels. Mais ça reste une amélioration mesurée dans un environnement précis.
ForgeTrain automatise plutôt la création de framework d’entraînement. Dit simplement, il aide à produire les briques qui servent à entraîner ou améliorer des modèles. C’est très utile, mais ça ne veut pas dire qu’une IA pilote seule toute la chaîne.
J’ai souvent vu la même illusion sur des missions data ou IA. Des workflows n8n ou des agents IA donnent vite l’impression d’être autonomes. En vrai, le cadre, les garde-fous, les accès, les critères de succès et la décision finale viennent encore des humains. C’est déjà puissant. Mais ce n’est pas encore une IA qui maîtrise toute sa propre évolution.
| Système | Ce qu’il automatise | Limite principale |
| A-Evolve-Training | Plusieurs tours de post-entraînement et d’amélioration contrôlée | Ne maîtrise pas toute la chaîne, des objectifs au déploiement |
| Ouroboros | Modification de certains outils, prompts ou éléments de fonctionnement | Reste dépendant d’un cadre défini par des humains |
| Darwin Gödel Machine | Amélioration de performances sur SWE-bench | Fonctionne dans un benchmark précis, pas dans un cycle IA complet |
| ForgeTrain | Automatisation de création de framework d’entraînement | Automatise l’outillage, pas la gouvernance complète de l’amélioration |
Pourquoi GPT-6 Astra reste intéressant ?
GPT-6 Astra est intéressant pour comprendre le RSI, parce qu’il réunit des capacités qu’on attendrait autour d’un futur système auto-améliorant, même s’il n’est pas présenté comme un RSI complet.
Le point important, c’est de ne pas confondre modèle très avancé et système récursif. Un modèle peut être excellent en raisonnement, en code, en usage d’ordinateur, en analyse scientifique, et rester totalement dépendant d’objectifs définis par des humains. Il peut proposer une amélioration, mais ne pas décider seul de la tester, de la valider, de la déployer, puis de recommencer la boucle.
Quand je parle de RSI, Recursive Self-Improvement, je parle d’un système capable d’améliorer ses propres capacités, puis d’utiliser cette nouvelle version pour s’améliorer encore. C’est cette boucle qui compte. Pas juste le fait d’être intelligent. Pas juste le fait de générer du bon code.
GPT-6 Astra reste intéressant parce qu’il touche plusieurs briques opérationnelles. Il peut raisonner sur un problème complexe. Il peut écrire ou modifier du code. Il peut utiliser des outils. Il peut naviguer dans un environnement informatique. Il peut contribuer à des tâches de recherche, par exemple formuler des hypothèses, lire des résultats, comparer des approches. J’ai vu ce genre de saut chez des clients avec des modèles moins avancés déjà : le vrai changement arrive quand le modèle ne répond plus seulement, mais agit dans une chaîne de travail.
Mais ça ne suffit pas. La puissance du modèle ne veut pas dire auto-amélioration récursive. C’est souvent là que les discussions partent dans le fantasme ou dans le déni. Côté business, il faut rester lucide : ces capacités peuvent accélérer la R&D, l’automatisation, le développement logiciel, mais elles doivent encore être encadrées par des objectifs, des tests, des garde-fous et des décisions humaines.
| Capacité | Utilité pour le RSI | Limite actuelle |
| Raisonnement complexe | Identifier des pistes d’amélioration et comparer plusieurs stratégies. | Le modèle ne garantit pas seul que ses conclusions sont vraies ou sûres. |
| Écriture et modification de code | Créer ou ajuster des composants logiciels qui pourraient améliorer un système. | Le code doit être testé, validé et intégré par un cadre externe. |
| Usage d’outils | Exécuter des tâches, lancer des analyses, manipuler des environnements. | L’autonomie dépend des permissions et des objectifs donnés. |
| Recherche scientifique | Aider à explorer des architectures, des méthodes d’entraînement ou des évaluations. | Contribuer à la recherche n’est pas équivalent à se réentraîner soi-même. |
| Navigation informatique | Relier raisonnement, action et observation dans un environnement réel. | Sans boucle autonome de décision et d’amélioration, ce n’est pas du RSI complet. |
Que peut-on attendre ensuite ?
La réponse courte : À court terme, les humains gardent la main. On définit encore les objectifs, les tests, l’infrastructure, les budgets, les risques acceptables et les décisions de mise en production. Une IA peut proposer, optimiser, comparer, parfois surprendre. Mais appuyer sur le bouton qui change vraiment un système critique, ça reste une responsabilité humaine.
Le Recursive Self-Improvement, ou RSI, c’est l’idée qu’un système améliore sa propre capacité à s’améliorer. Dit comme ça, ça paraît presque mécanique. En pratique, il faut une boucle très solide : choisir quoi améliorer, tester si l’amélioration marche vraiment, garder ce qui apporte un gain, rejeter ce qui dérive, puis améliorer la boucle elle-même. C’est exactement là que ça devient dur. Parce qu’un modèle peut gagner sur un test et perdre en fiabilité réelle. Il peut devenir plus rapide mais moins explicable. Il peut optimiser une métrique et casser le reste. J’ai déjà vu ça chez un client avec des automatisations beaucoup plus simples : dès que le critère de succès est flou, le système apprend surtout à contourner le problème.
Si ces boucles progressent, l’impact peut devenir sérieux. En santé, on peut imaginer de meilleurs assistants de diagnostic, plus prudents et mieux évalués. En sécurité, des agents capables de détecter des failles, mais aussi de générer des risques, donc à manier avec des garde-fous forts. En recherche scientifique, l’IA pourrait accélérer les hypothèses, les simulations, la lecture d’articles. En automatisation logicielle, elle pourrait corriger, tester et documenter du code avec moins de supervision. Même l’intelligence émotionnelle et l’accompagnement peuvent évoluer, avec des systèmes plus sensibles au contexte humain. Je parle bien de potentiel, pas de promesse. La différence est importante.
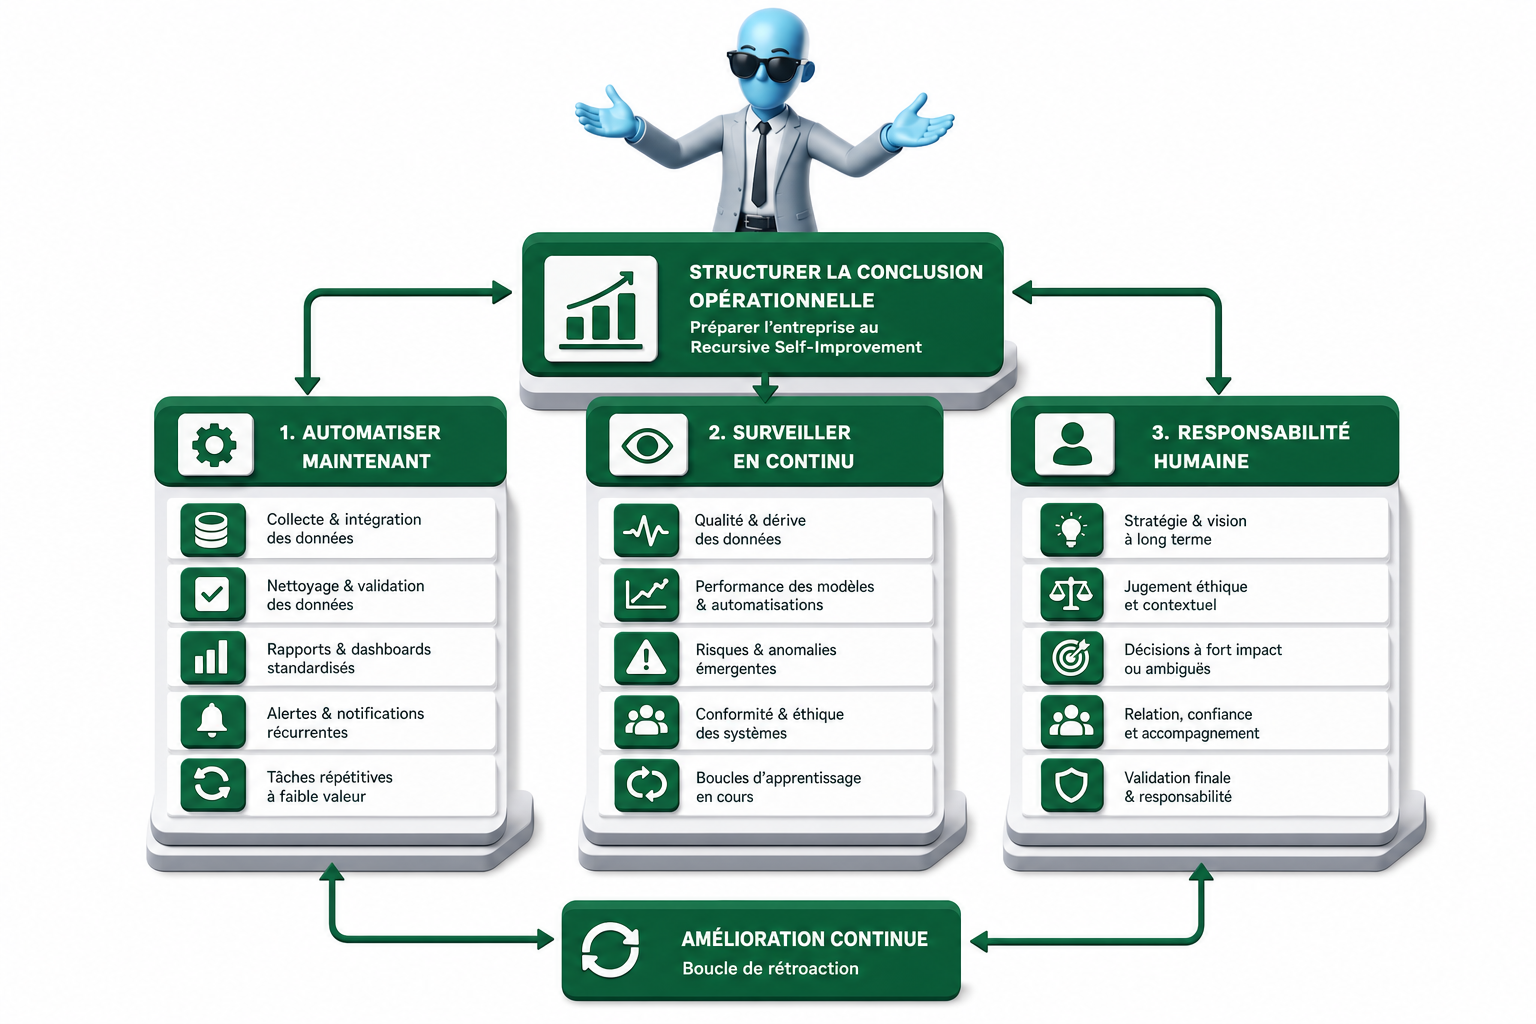
Pour les entreprises, le bon réflexe aujourd’hui n’est pas d’attendre une IA magique qui s’améliore toute seule. C’est de préparer le terrain. Documenter les workflows, clarifier les critères de qualité, créer des jeux de tests, conserver les traces, définir les garde-fous. C’est moins spectaculaire qu’une démo d’agent autonome, mais c’est ce qui permettra d’en intégrer demain sans perdre le contrôle.
| À automatiser maintenant | Les tâches répétitives, les contrôles simples, la génération de brouillons, les analyses de données cadrées, les tests logiciels standardisés. |
| À surveiller | Les dérives de qualité, les hallucinations, les décisions non traçables, les accès aux données sensibles, les effets de bord sur les processus métier. |
| À garder humain | Les objectifs, les arbitrages éthiques, la validation finale, la responsabilité, le choix de mettre en production ou non. |
Alors on en est où avec l’IA qui s’améliore seule ?
Le Recursive Self-Improvement n’est pas encore là au sens fort. Ce qu’on voit aujourd’hui, ce sont surtout des morceaux du cycle qui deviennent automatisables : post-entraînement, agents de code, tests, workflows, choix de stratégies. La vraie bascule arriverait quand une IA pourrait conserver ses gains, les réutiliser, améliorer ses méthodes et le faire sous contrôle fiable. Pour l’instant, les humains définissent encore les objectifs, les évaluations et la mise en production. Mon conseil est simple : préparez vos données, vos workflows et vos garde-fous maintenant. Le bénéfice pour vous, c’est d’adopter ces systèmes plus vite, sans subir leur complexité.
FAQ
- Qu’est-ce que le Recursive Self-Improvement en IA ?
Le Recursive Self-Improvement, ou RSI, désigne une IA capable d’utiliser ses propres améliorations pour générer de nouvelles améliorations. Le point important, c’est la continuité. Une meilleure réponse ponctuelle ne suffit pas. Il faut que le gain soit conservé et réutilisé. - Est-ce que le RSI existe déjà aujourd’hui ?
Pas encore au sens complet. Certains systèmes automatisent déjà des parties du cycle, comme l’entraînement, le code, les tests ou l’optimisation d’agents. Mais les humains gardent encore le contrôle des objectifs, des évaluations, de l’infrastructure et du déploiement. - Quelle est la différence entre optimisation et RSI ?
L’optimisation améliore une tâche dans un cadre donné. Le RSI va plus loin : le système doit capitaliser sur ses progrès, les intégrer durablement, puis s’en servir pour améliorer sa prochaine version ou sa propre méthode d’amélioration. - Pourquoi les agents de code sont importants pour le RSI ?
Parce qu’un agent capable de lire, écrire, tester et modifier du code peut agir sur une partie de son environnement technique. C’est une brique utile pour l’auto-amélioration, même si ça ne suffit pas à prouver un RSI complet. - Que doivent faire les entreprises maintenant ?
Le plus utile est de structurer les workflows, les données, les critères de qualité, les tests et les garde-fous. Avant de parler d’IA auto-améliorante, il faut déjà savoir mesurer ce qui marche, tracer les décisions et sécuriser les automatisations.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent passer de l’expérimentation IA à des workflows fiables, mesurables et utiles en production. J’ai travaillé avec des références comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez cadrer vos projets IA, automatisation ou data sans bullshit, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.