
On relie deux DGX Spark par RoCE, puis vLLM répartit le modèle entre les machines avec la parallélisation tensorielle. Le cluster peut ainsi charger des modèles de 150 à 160 Go. Voici ce que ça change en pratique, ses limites réseau et ses performances.
Pourquoi regrouper deux DGX Spark ?
Deux DGX Spark regroupés peuvent exécuter localement un modèle trop volumineux pour la mémoire d’une seule machine. Chaque DGX Spark dispose de 128 Go de mémoire. Le cluster répartit le même modèle entre les deux unités afin que son exécution s’appuie sur les ressources de chacune.
Cette approche répond à un besoin précis : lancer une inférence locale avec un modèle dont les besoins mémoire dépassent les 128 Go disponibles sur un Spark. L’inférence consiste à utiliser un modèle déjà entraîné pour produire des réponses ou des résultats à partir de nouvelles données.
Exemples de modèles concernés :
- DeepSeek V4 Flash nécessite environ 150 à 160 Go de mémoire, selon les informations disponibles.
- La grande version de Qwen3-Next relève aussi de cette catégorie de modèles trop volumineux pour un seul DGX Spark.
Le regroupement ne transforme pas les deux machines en un seul appareil doté d’une mémoire physiquement fusionnée. Chaque unité conserve sa propre mémoire. C’est le modèle qui est réparti entre elles pour permettre son exécution sur le cluster.
La distinction compte : il ne s’agit pas simplement de lancer deux copies indépendantes du modèle, une sur chaque machine. L’objectif est de répartir un même modèle entre les deux DGX Spark pour réaliser de l’inférence locale, alors qu’il ne tient pas dans la mémoire d’une seule unité.
Comment connecter les deux machines ?
Les deux DGX Spark se connectent par une liaison haut débit RoCE, qui permet aux machines d’échanger des données directement entre leurs mémoires. RoCE signifie « RDMA over Converged Ethernet » : RDMA, pour « Remote Direct Memory Access », désigne l’accès direct à la mémoire d’une autre machine.
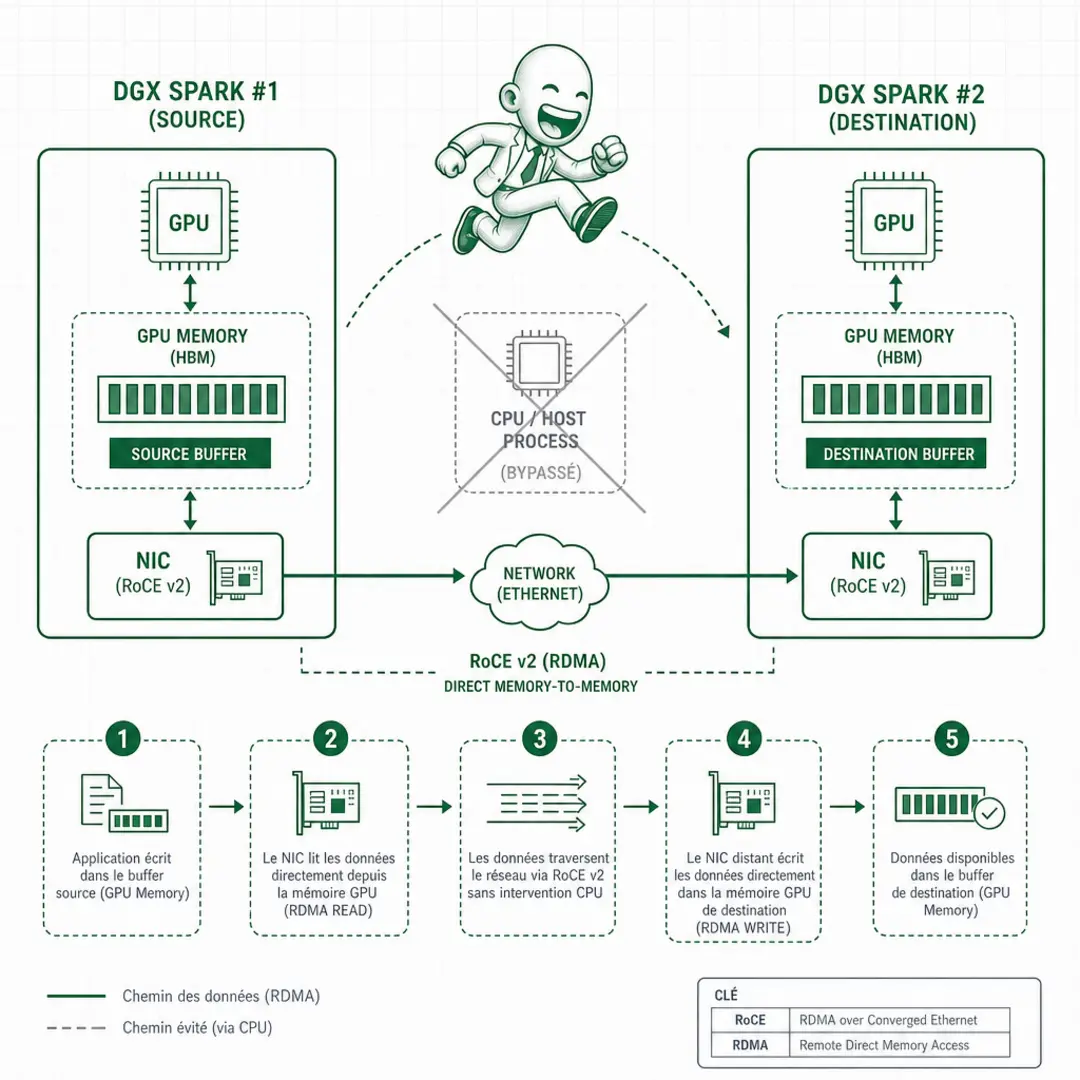
Lors d’une inférence répartie, cette liaison transporte les données nécessaires aux échanges entre les deux systèmes. Le processeur n’a pas à copier lui-même chaque bloc de données : il organise les opérations, mais le transfert de la charge utile passe directement de mémoire à mémoire. Cette réduction des intermédiaires diminue la latence et libère le processeur pour les autres tâches.
Le débit annoncé pour cette connexion est de 200 Go/s. Dans les essais réalisés, le débit mesuré était d’environ 111 Go/s. L’écart est notable, mais il n’a pas été isolé pour en mesurer précisément le coût sur les performances d’inférence. On ne peut donc pas lui attribuer, à lui seul, une baisse donnée du débit de génération ou une hausse donnée du temps de réponse.
- La liaison RoCE sert aux échanges de données entre les deux machines.
- L’accès direct à la mémoire évite de faire transiter les données par le processeur.
- Le débit observé doit être distingué du débit annoncé : les essais ont mesuré environ 111 Go/s, et l’impact précis de l’écart n’a pas été établi.
Le débit réseau ne suffit pas, à lui seul, à caractériser l’inférence distribuée. Le découpage du modèle et la quantité de données échangées influencent aussi les performances. Je n’indique pas de référence de câble, de commande réseau ni de procédure de configuration : ces éléments ne sont pas établis ici.
Comment vLLM répartit-il le modèle ?
vLLM répartit le calcul d’un même modèle entre les deux machines à l’aide de la parallélisation tensorielle. Chaque couche du réseau est divisée entre les nœuds : les deux DGX Spark détiennent et calculent chacun une partie de cette couche, au lieu d’exécuter chacun le modèle complet.
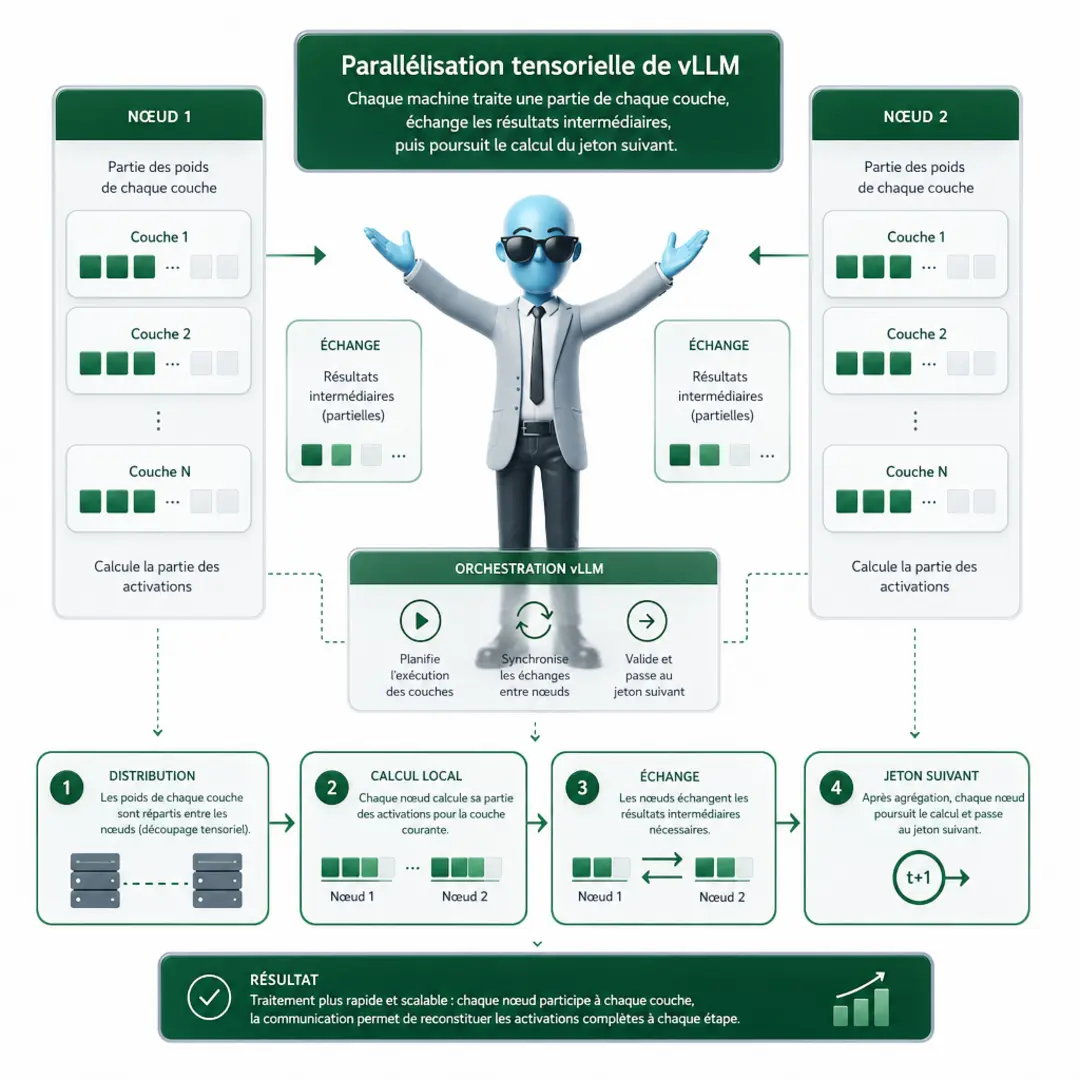
Pour générer un jeton, chaque machine traite sa partie des opérations de la couche. Les résultats intermédiaires sont ensuite échangés entre les nœuds, puis le calcul continue sur la couche suivante. Ce cycle se répète pour chaque jeton généré. La communication entre les machines fait donc partie du chemin critique : elle doit rester suffisamment rapide pour ne pas annuler le gain obtenu en répartissant le calcul.
Avec un modèle quantifié autour de quatre bits — une représentation qui réduit la mémoire nécessaire aux poids —, la répartition peut mobiliser un peu plus de 100 Go sur chaque Spark. Il reste alors de la mémoire pour le contexte, notamment les jetons déjà traités ou générés, ainsi que pour le système et les autres besoins d’exécution. La marge disponible dépend du modèle et de la longueur du contexte.
Il faut distinguer cette approche d’une réplication du modèle. En parallélisation tensorielle, chaque Spark héberge une partie du modèle et contribue à chaque génération. Avec une copie complète sur chaque unité, les deux machines disposent chacune de tous les poids : elles peuvent alors traiter des requêtes différentes, mais ne combinent pas automatiquement leur mémoire pour faire tenir un modèle plus grand.
Quels modèles justifient deux DGX Spark ?
Deux DGX Spark sont utiles lorsqu’un modèle ne tient pas dans les 128 Go d’une seule machine, même quantifié en quatre bits. La quantification réduit la mémoire occupée par les poids en utilisant une représentation numérique plus compacte, mais elle ne supprime pas la contrainte de capacité.
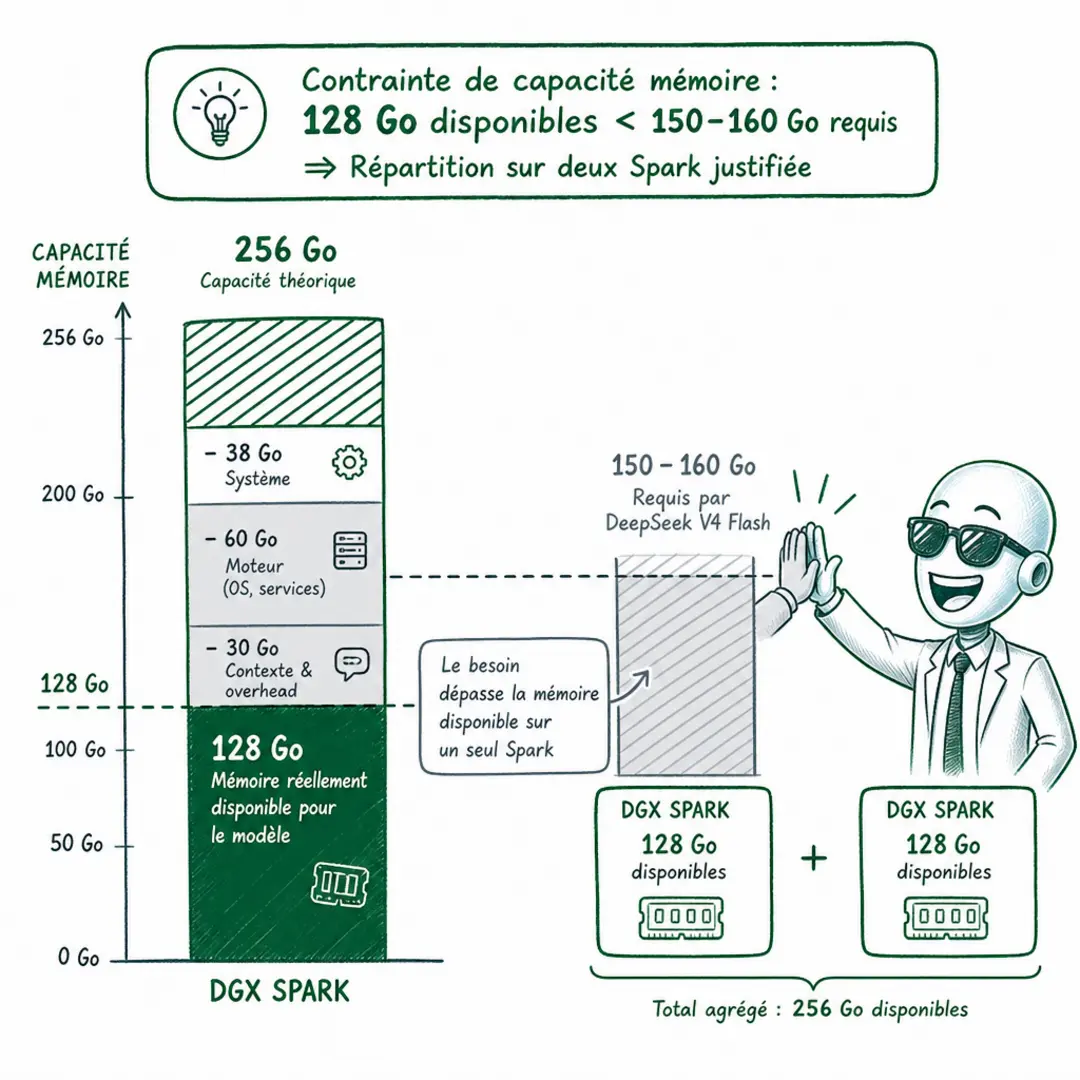
DeepSeek V4 Flash est estimé à environ 150 à 160 Go de mémoire pour ses poids en quatre bits. Il dépasse donc déjà les 128 Go disponibles sur un Spark, avant même de réserver de la mémoire au contexte et au système. La grande version de Qwen3-Next fait aussi partie des modèles qui peuvent justifier une répartition sur deux machines, selon sa taille réelle et la quantification retenue.
Deux machines permettent de répartir les poids du modèle pour l’inférence. Ça ne signifie pas que les 256 Go annoncés deviennent automatiquement une mémoire unique, entièrement disponible : une partie reste nécessaire au système, au moteur d’inférence, aux activations et au contexte. Le contexte correspond aux tokens conservés pour traiter la conversation ou la séquence en cours. Plus il est long, plus il consomme de mémoire.
Le choix dépend donc du compromis entre la taille des poids, le niveau de quantification et la mémoire restante pour le contexte. Une quantification plus forte peut faire tenir davantage de modèles, mais son impact sur la qualité dépend du modèle et de l’usage. Il n’existe pas de configuration universelle : vérifiez la mémoire réellement disponible avec votre moteur d’inférence et la longueur de contexte visée.
| Situation | Ce que permet le cluster | Point de vigilance |
| Modèle supérieur à 128 Go en quatre bits, comme DeepSeek V4 Flash estimé à 150–160 Go | Répartir les poids du modèle sur deux machines pour l’inférence | Prévoir aussi la mémoire du contexte, du système et du moteur d’inférence |
| Grande version de Qwen3-Next | Envisager une répartition sur deux machines si le modèle dépasse la capacité d’un Spark | La capacité nécessaire dépend de la taille réelle et de la quantification retenue |
| Modèle qui tient sur un seul Spark | Conserver une seule machine pour l’inférence | La mémoire disponible pour le contexte varie selon la taille des poids et le niveau de quantification |
Quelles performances attendre du cluster ?
Les performances du cluster dépendent du modèle, du moteur d’inférence et de la quantification, c’est-à-dire du niveau de précision utilisé pour représenter les poids du modèle. Les résultats disponibles face au Mac Studio Apple M5 Ultra ne désignent pas de vainqueur systématique : sur DeepSeek, les vitesses de génération sont proches ; sur Qwen, le Mac est avantagé. Les deux DGX Spark traitent plus rapidement les longs contextes et offrent un meilleur débit lorsque plusieurs utilisateurs interrogent le modèle en parallèle.
Ces écarts reflètent des charges différentes. La vitesse de génération pour une requête isolée ne prédit pas le débit obtenu sous concurrence. De même, le traitement d’un long contexte dépend de la longueur du prompt, tandis que la génération dépend notamment du nombre de jetons produits. Comparer des résultats sans contrôler ces paramètres conduit vite à des conclusions trompeuses.
Le débit RoCE pratique mesuré était d’environ 111 Go/s, contre 200 Go/s annoncés. Cet écart décrit le débit observé par rapport au débit théorique annoncé ; il ne permet pas, à lui seul, de chiffrer une perte de performances en inférence.
Pour lire un benchmark, vérifiez au minimum les éléments suivants :
- Le modèle et sa version, ainsi que la quantification utilisée.
- Le moteur d’inférence et sa configuration.
- La longueur du prompt et le nombre de jetons générés.
- Le nombre d’utilisateurs simultanés et le niveau de concurrence.
- La métrique publiée : latence, vitesse par requête ou débit total.
Sans ces informations, un chiffre isolé ne permet pas de comparer utilement deux plateformes. Les résultats indiquent plutôt où chaque configuration est la plus adaptée, pas laquelle est toujours la plus rapide.
Que retenir avant de monter votre cluster DGX Spark ?
Deux DGX Spark reliés en RoCE peuvent exécuter localement des modèles qui dépassent les 128 Go d’une seule machine. vLLM répartit le calcul par parallélisation tensorielle ; la mémoire combinée rend accessibles des modèles comme DeepSeek V4 Flash et la grande version de Qwen3-Next. Le débit réseau mesuré, environ 111 Go/s, reste inférieur aux 200 Go/s annoncés, et son coût précis n’a pas été établi. Les benchmarks montrent des résultats variables selon le modèle, le moteur et la quantification : le cluster se distingue notamment sur les longs contextes et l’usage multi-utilisateur. Vous pouvez ainsi évaluer si cette architecture répond à vos besoins d’inférence locale sans vous fier à un seul chiffre.
FAQ
-
Pourquoi connecter deux NVIDIA DGX Spark ?
Le cluster répartit le modèle entre les deux machines et permet de charger des modèles qui dépassent les 128 Go de mémoire d’un seul Spark, comme DeepSeek V4 Flash. -
Quel réseau relie les deux DGX Spark ?
La liaison décrite utilise RoCE et un accès direct à la mémoire distante. Le débit annoncé est de 200 Go/s ; le débit mesuré dans les essais était d’environ 111 Go/s. -
Comment vLLM distribue-t-il le modèle sur deux machines ?
La parallélisation tensorielle divise chaque couche entre les deux nœuds. Ceux-ci calculent leur partie pour chaque jeton, échangent les résultats, puis poursuivent le calcul. -
Quels modèles peuvent bénéficier de ce cluster ?
DeepSeek V4 Flash, qui nécessite environ 150 à 160 Go, et la grande version de Qwen3-Next sont cités comme des modèles pouvant dépasser la mémoire d’un seul Spark. -
Le cluster est-il toujours plus rapide qu’un Mac Studio ?
Non. Les vitesses de génération sont proches sur DeepSeek, le Mac est avantagé sur Qwen, et le cluster traite plus rapidement les longs contextes et offre un meilleur débit avec plusieurs utilisateurs. Les résultats varient aussi selon le moteur d’inférence et la quantification.
A propos de l’auteur
Je suis Franck Scandolera, expert en Data engineering et en automatisation IA. Je conçois des architectures et des workflows qui rendent les modèles exploitables dans des applications métier, avec une attention particulière aux contraintes de calcul, de mémoire et de performance.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.