
Kolibri-1 peut s’exécuter localement avec des accélérateurs de centre de données, mais pas avec une configuration GPU standard. Je détaille la VRAM réellement nécessaire, les configurations matérielles viables et le rôle du package aleph-alpha-inference avec vLLM.
De quoi Kolibri-1 a-t-il besoin pour tourner en local ?
Kolibri-1 demande un ou plusieurs GPU de centre de données capables de gérer ses poids en FP8 et la mémoire utilisée pendant l’inférence. C’est un modèle MoE (« Mixture of Experts », ou mélange d’experts) de 78 milliards de paramètres, dont environ 3,46 milliards sont activés pour chaque jeton généré. Pour l’exécuter en local, la voie prévue passe par vLLM avec un plugin dédié à Kolibri-1.
Le format FP8 stocke les poids sur 8 bits et les ramène à environ 78 Go. C’est une estimation de la taille des poids, pas de la mémoire vidéo totale nécessaire pour faire tourner le modèle. Une machine avec tout juste 78 Go de VRAM ne suffit donc pas forcément.
La mémoire réellement consommée dépend aussi de plusieurs éléments :
- Le cache KV, qui conserve les clés et valeurs d’attention des jetons déjà traités. Il augmente avec la longueur du contexte et le nombre de requêtes simultanées.
- Les activations, les données intermédiaires produites pendant le calcul. Leur volume varie selon la configuration et la charge.
- Le service d’inférence, qui mobilise de la mémoire pour vLLM, le plugin, les tampons et les opérations du GPU.
La charge ne se résume donc pas à « 78 Go de poids = 78 Go de VRAM ». Il faut aussi garder une marge pour le contexte et le débit demandé. Dans un déploiement multi-GPU, vLLM peut répartir le modèle entre plusieurs accélérateurs, à condition que la configuration matérielle et le plugin le prennent en charge.
Le choix du GPU doit tenir compte de sa capacité mémoire, mais aussi de son support du FP8 et de sa compatibilité avec la pile logicielle requise. Les accélérateurs de centre de données sont la cible de Kolibri-1 ; une carte graphique grand public ne constitue pas un remplacement équivalent. La distinction importante est celle entre la taille des poids et la mémoire nécessaire en pratique : c’est elle qui détermine si le modèle tient sur votre configuration, et avec quelle marge pour servir des requêtes.
Quelle VRAM faut-il réellement prévoir ?
Les poids FP8 occupent environ 78 Go de mémoire vidéo, mais cette capacité ne suffit pas à déterminer le GPU nécessaire. C’est uniquement la mémoire réservée aux paramètres du modèle, pas le budget total d’exécution.
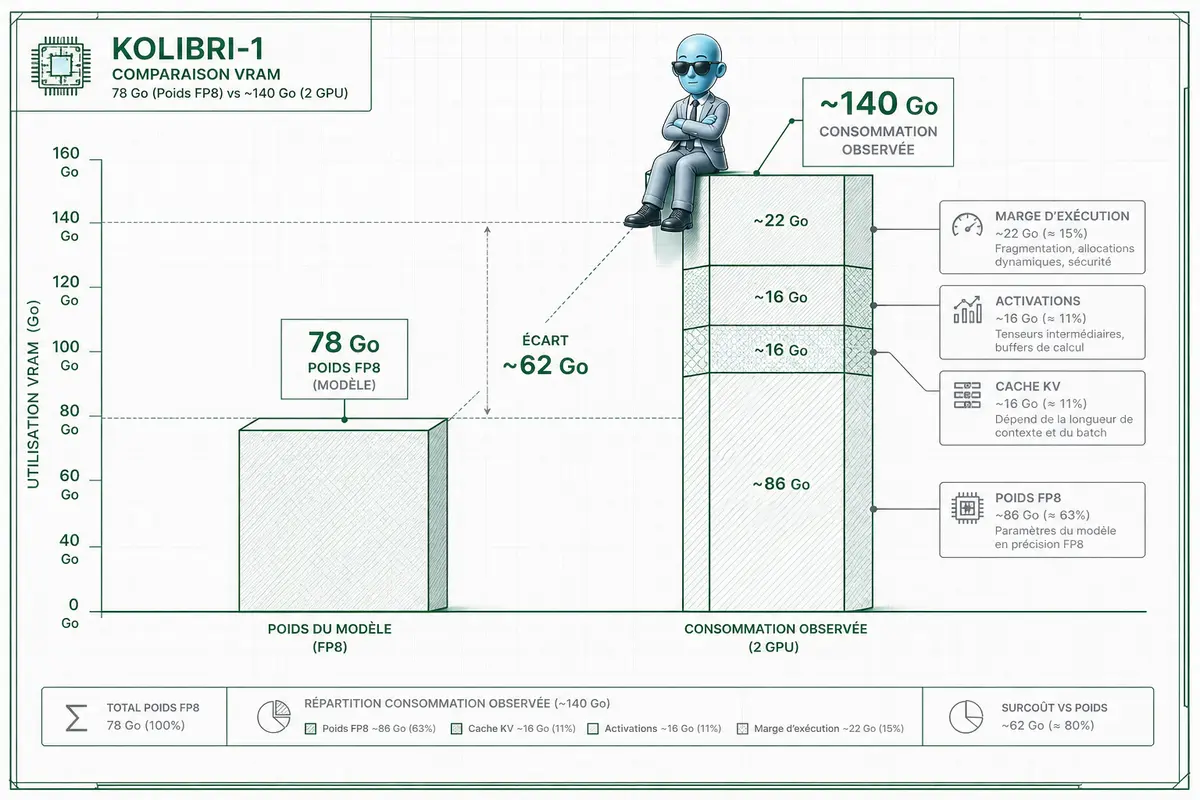
Il faut aussi compter le cache KV — le cache des clés et valeurs utilisé pour conserver le contexte des tokens déjà traités — ainsi que les activations temporaires produites pendant le calcul. Ces besoins varient selon la longueur des requêtes, la taille des lots et le nombre de requêtes traitées simultanément. Une longue séquence augmente notamment le cache KV ; avec plusieurs requêtes en parallèle, la consommation grimpe encore.
Un test rapporté sur deux GPU a observé environ 140 Go de mémoire vidéo utilisés au total. C’est une mesure constatée dans cette configuration, pas une valeur universelle ni une garantie pour toutes les charges. La consommation réelle dépend de la longueur des contextes, du parallélisme, du moteur d’inférence et de ses réglages.
Le cache KV en FP8 réduit son empreinte mémoire en utilisant une représentation plus compacte. C’est utile, surtout pour les longues requêtes, mais ça ne supprime ni le coût des poids ni celui des activations. Pour Kolibri-1, prévoyez donc plusieurs GPU de grande capacité et gardez une marge : additionner les capacités nominales ne garantit pas que toute cette mémoire sera disponible ou exploitable par le modèle.
| Poids du modèle | Environ 78 Go en FP8. |
| Mémoire additionnelle | Cache KV, activations et marge d’exécution ; variable selon la charge. |
| Mesure observée | Environ 140 Go sur deux GPU dans un test rapporté, sans garantie universelle. |
Quelles configurations matérielles sont compatibles ?
Pour exécuter Kolibri-1 en local, il faut une configuration de calcul haut de gamme : le minimum indiqué est de deux A100 80 Go, deux H100 SXM5, un H200, un B200 ou un B300. Les configurations recommandées apportent davantage de marge pour le service du modèle.
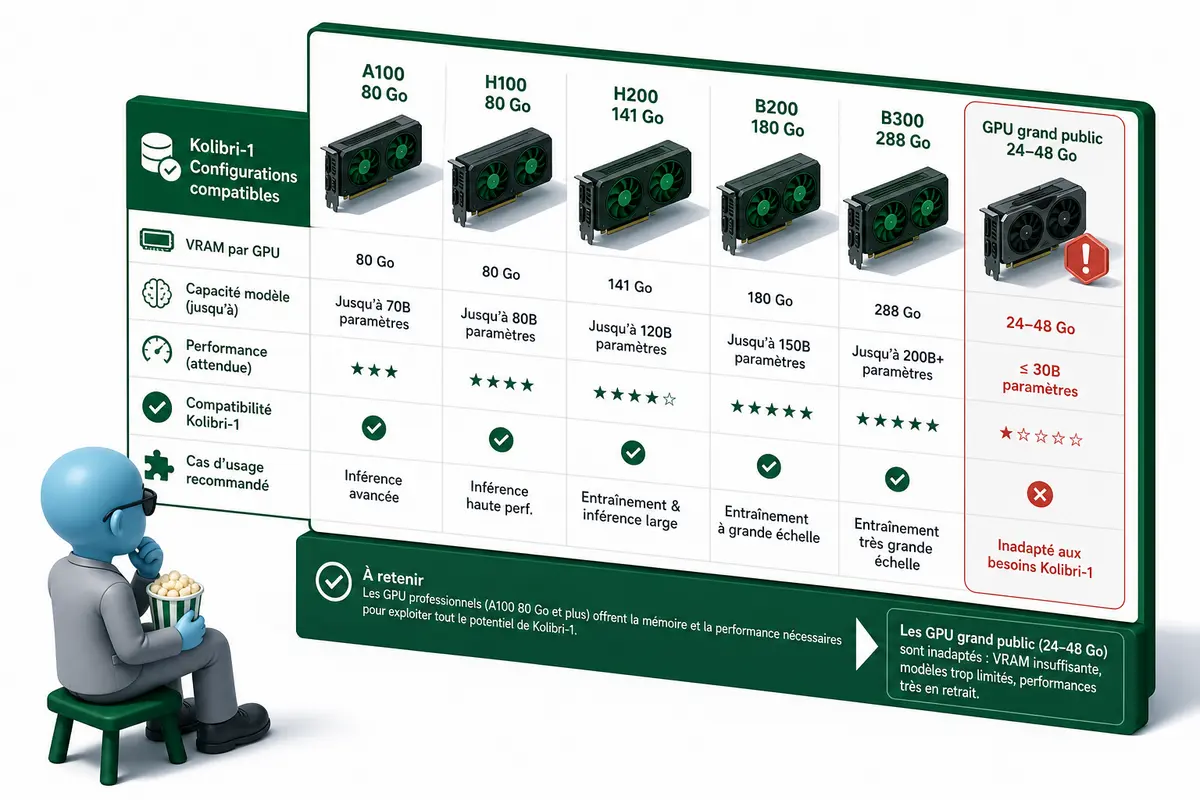
| Niveau | Configuration GPU |
| Minimum | Deux A100 80 Go |
| Minimum | Deux H100 SXM5 |
| Minimum | Un H200 |
| Minimum | Un B200 |
| Minimum | Un B300 |
| Recommandé | Deux H100 SXM5 |
| Recommandé | Deux H200 |
| Recommandé | Un B200 |
| Recommandé | Un B300 |
Les GPU grand public disposant de 24 à 48 Go de mémoire ne sont pas présentés comme viables pour ce modèle. La mémoire vidéo disponible et la capacité de calcul sont déterminantes : une carte grand public ne devient pas adaptée simplement parce qu’elle peut charger une partie des poids du modèle.
Le matériel ne suffit pas. Il faut aussi un logiciel de service compatible avec Kolibri-1, c’est-à-dire un serveur d’inférence qui charge le modèle et expose son accès aux applications. Sa configuration doit correspondre aux GPU disponibles et, avec plusieurs cartes, gérer le calcul distribué entre GPU — souvent appelé parallélisme tensoriel. Il faut également vérifier la compatibilité entre le serveur, les pilotes NVIDIA et la version de CUDA, la plateforme logicielle utilisée pour les GPU NVIDIA.
Si vous n’avez pas ces accélérateurs sur site, la location d’une instance GPU dans le cloud est une option. Vérifiez avant de réserver le modèle exact de GPU, la mémoire disponible et la prise en charge par le logiciel de service choisi. Une instance annoncée comme « GPU disponible » ne garantit pas, à elle seule, qu’elle répond aux besoins de Kolibri-1.
Comment installer et servir Kolibri-1 avec vLLM ?
Une installation standard de vLLM ne suffit pas pour servir Kolibri-1. J’utilise le package aleph-alpha-inference ou le conteneur préconstruit associé : il fournit la version compatible de vLLM ainsi que les analyseurs nécessaires au format de sortie du modèle.
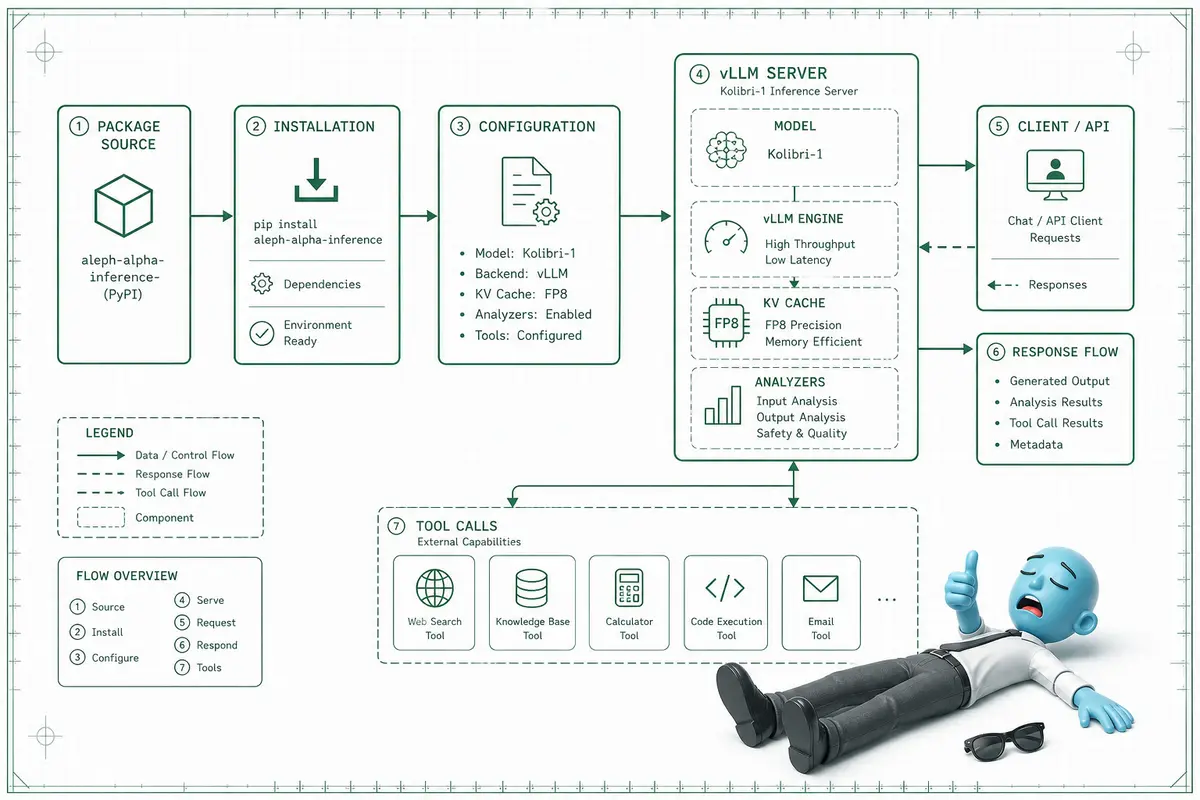
L’installation Python se fait avec cette commande :
pip install aleph-alpha-inference
Au service, il faut activer le cache KV en FP8, les analyseurs de raisonnement et d’appels d’outils, ainsi que le choix automatique des outils. Le cache KV stocke les états intermédiaires de l’attention ; le format FP8 réduit leur empreinte mémoire, au prix d’exigences de compatibilité matérielle et logicielle. Les analyseurs interprètent les sorties structurées de Kolibri-1 pour préserver correctement le raisonnement et router les appels d’outils.
Le contexte par défaut est de 262 144 jetons. Des configurations modifiées ont été validées au-delà d’un million de jetons, mais cette capacité dépend de la configuration et des ressources disponibles. Kolibri-1 expose quatre niveaux de raisonnement et prend en charge les appels d’outils. L’activation de ces capacités ne doit pas être supposée automatique : elle dépend du mode de service configuré.
Je ne donne pas de commande de lancement générique, car les noms d’options et leur syntaxe dépendent du package ou du conteneur utilisé. Vérifiez la commande exacte dans la documentation correspondante, ainsi que les paramètres requis pour le cache FP8, les analyseurs et la sélection automatique des outils. Reprendre une commande vLLM standard sans ces éléments peut produire un service qui démarre, mais interprète mal les sorties du modèle ou ne route pas ses appels d’outils.
Votre infrastructure est-elle prête pour Kolibri-1 ?
Kolibri-1 ne se dimensionne pas à partir de ses seuls poids FP8, qui occupent environ 78 Go. Le cache KV, les activations et les requêtes longues portent les besoins réels beaucoup plus haut ; un test sur deux GPU a atteint environ 140 Go. Les configurations à retenir reposent sur des accélérateurs de centre de données, notamment les A100, H100, H200, B200 ou B300, tandis que les GPU grand public de 24 à 48 Go ne sont pas présentés comme viables. Côté logiciel, il faut le package aleph-alpha-inference ou son conteneur, pas une installation standard de vLLM. Vous pouvez ainsi évaluer clairement le matériel et le mode de déploiement nécessaires avant de lancer vos tests.
FAQ
-
Combien de VRAM faut-il pour exécuter Kolibri-1 ?
Les poids FP8 occupent environ 78 Go, mais le cache KV, les activations et le service augmentent la consommation. Un test sur deux GPU a rapporté environ 140 Go utilisés. -
Un GPU grand public de 48 Go suffit-il ?
Les GPU grand public de 24 à 48 Go ne sont pas présentés comme viables pour exécuter Kolibri-1 localement. -
Quelles configurations matérielles sont indiquées ?
Le minimum indiqué comprend deux A100 80 Go, deux H100 SXM5, un H200, un B200 ou un B300. Les recommandations comprennent deux H100 SXM5, deux H200, un B200 ou un B300. -
Peut-on utiliser une installation standard de vLLM ?
Non. Kolibri-1 nécessite le package aleph-alpha-inference, qui fournit la version compatible de vLLM et les analyseurs nécessaires, ou le conteneur préconstruit. -
Quelle longueur de contexte est prise en charge ?
La longueur de contexte par défaut est de 262 144 jetons. Une validation au-delà d’un million est mentionnée après modification de la configuration.
A propos de l’auteur
Je suis Franck Scandolera, expert en data engineering et en automatisation IA. J’accompagne les équipes dans le déploiement de modèles et de workflows IA en tenant compte des contraintes d’infrastructure, de performance et d’intégration métier.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.