
IQuest-Q1 s’auto-héberge sur un serveur multi-GPU, avec un déploiement documenté sur huit GPU via SGLang ou vLLM. Je détaille son architecture MoE, ses besoins mémoire, les points à vérifier avant lancement et ses limites pour éviter de confondre paramètres actifs et mémoire réellement nécessaire.
Qu’est-ce qui distingue IQuest-Q1 ?
IQuest-Q1 est un modèle open-weight orienté vers le codage agentique, le raisonnement et l’utilisation d’outils en plusieurs étapes. Il est conçu pour s’intégrer à Claude Code et Codex CLI. Le modèle est textuel, et son comportement sur les tâches agentiques reste précoce : des erreurs sont possibles.
Ses principales caractéristiques d’architecture sont les suivantes :
| Paramètres | Environ 320 milliards au total, dont environ 15 milliards activés par jeton. |
| Structure | 88 couches Transformer, une dimension cachée de 3 072, 48 têtes de requête et 8 têtes clé/valeur. |
| Experts | Routage de 8 experts parmi 256 à chaque étape concernée. Cette architecture à experts permet de n’activer qu’une partie des paramètres pour traiter un jeton. |
| Attention | Trois couches d’attention à fenêtre glissante de 4 096 jetons alternent avec une couche d’attention complète. |
| Contexte et prédiction | RoPE partiel appliqué sur 32 dimensions, fenêtre de contexte de 524 288 jetons et prédiction multi-jetons récursive. |
La fenêtre annoncée est de 524 288 jetons. Le libellé client « 1m » associé à Claude Code ne doit pas être interprété comme la limite réelle de contexte d’IQuest-Q1 : la limite indiquée pour le modèle est de 524 288 jetons.
Le point important pour l’auto-hébergement est la différence entre calcul et mémoire. Les quelque 15 milliards de paramètres activés réduisent le calcul nécessaire pour traiter chaque jeton, comparé à l’activation de l’ensemble des 320 milliards. Mais les poids de tous les experts doivent rester disponibles en mémoire. Le faible nombre de paramètres actifs ne réduit donc pas à lui seul la mémoire nécessaire pour stocker le modèle. C’est cette contrainte qui détermine le matériel requis pour le faire tourner.
Quelle configuration matérielle prévoir ?
Le déploiement documenté d’IQuest-Q1 vise une configuration à huit GPU et demande une mémoire importante. Les quelque 15 milliards de paramètres actifs par token ne donnent pas la mémoire nécessaire au chargement du modèle : les poids des quelque 320 milliards de paramètres doivent être stockés, même si seule une partie est activée pour chaque token.
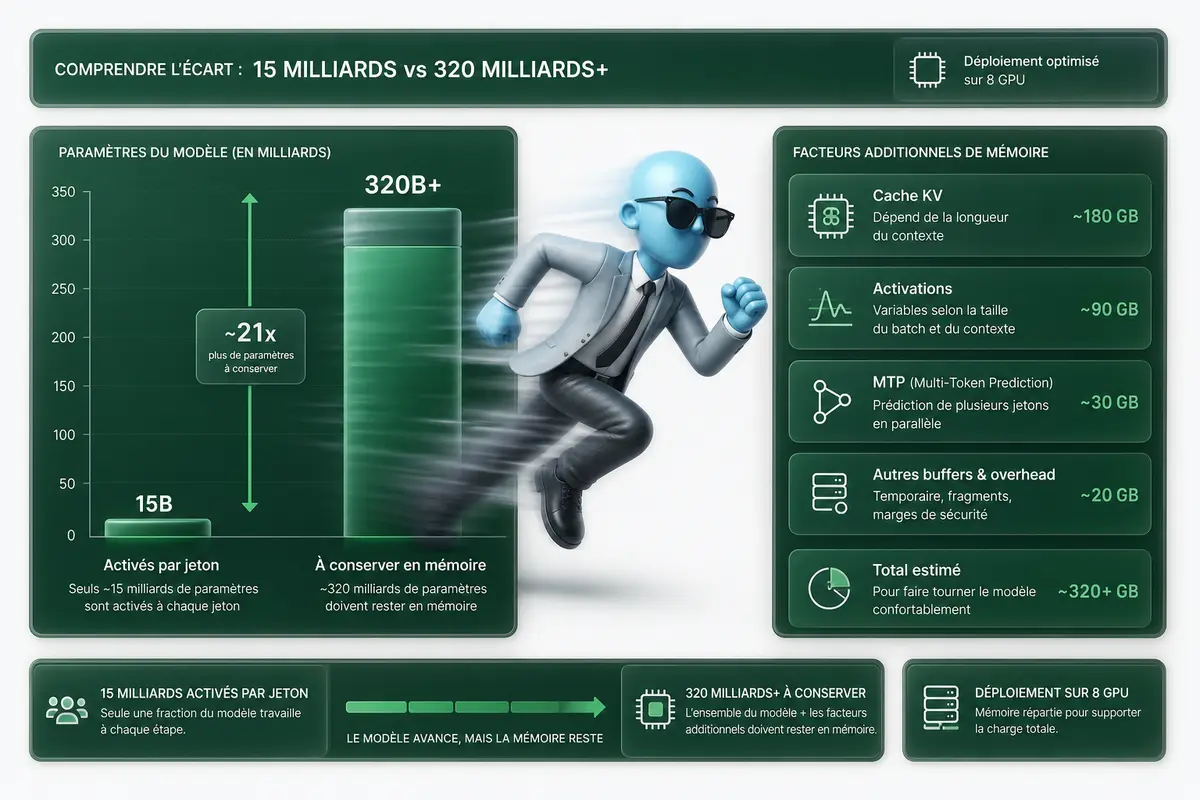
En bfloat16, les poids seuls occupent plusieurs centaines de gigaoctets. Il faut aussi réserver de la mémoire au cache KV — les clés et valeurs conservées pour générer les tokens suivants —, aux activations pendant l’inférence et au modèle brouillon MTP. MTP, ou prédiction multi-token, est un mécanisme de décodage qui ajoute ses propres besoins mémoire. La longueur du contexte et le nombre de requêtes traitées simultanément font varier la taille du cache KV.
Les configurations de référence de SGLang et de vLLM utilisent huit GPU. Je recommande donc un serveur multi-GPU ou une instance cloud dimensionnée pour répartir les poids entre plusieurs cartes et conserver une marge mémoire pour l’exécution. Une machine qui dispose d’assez de mémoire au total peut quand même échouer si la mémoire n’est pas répartie comme attendu ou si la mémoire disponible par GPU est insuffisante.
Des versions quantifiées ou à précision réduite peuvent exister ou émerger dans la communauté. Elles restent à vérifier au cas par cas : je ne les présente pas comme des options officielles confirmées pour IQuest-Q1.
| Facteur | Impact mémoire |
| Poids du modèle | Principal poste : les quelque 320 milliards de paramètres doivent être chargés. |
| Cache KV | Augmente avec le contexte et le nombre de requêtes simultanées. |
| Activations et MTP | Ajoutent une consommation mémoire pendant l’inférence. |
| Configuration GPU | Huit GPU dans les références SGLang et vLLM ; prévoir une marge. |
Une fois cette capacité matérielle validée, l’étape suivante consiste à choisir le moteur d’inférence : SGLang ou vLLM.
Comment choisir entre SGLang et vLLM ?
Les deux moteurs sont documentés pour déployer IQuest-Q1. Je choisirais SGLang ou vLLM selon l’environnement que vous pouvez exploiter, pas sur la base d’une différence de performances qui n’est pas établie ici.
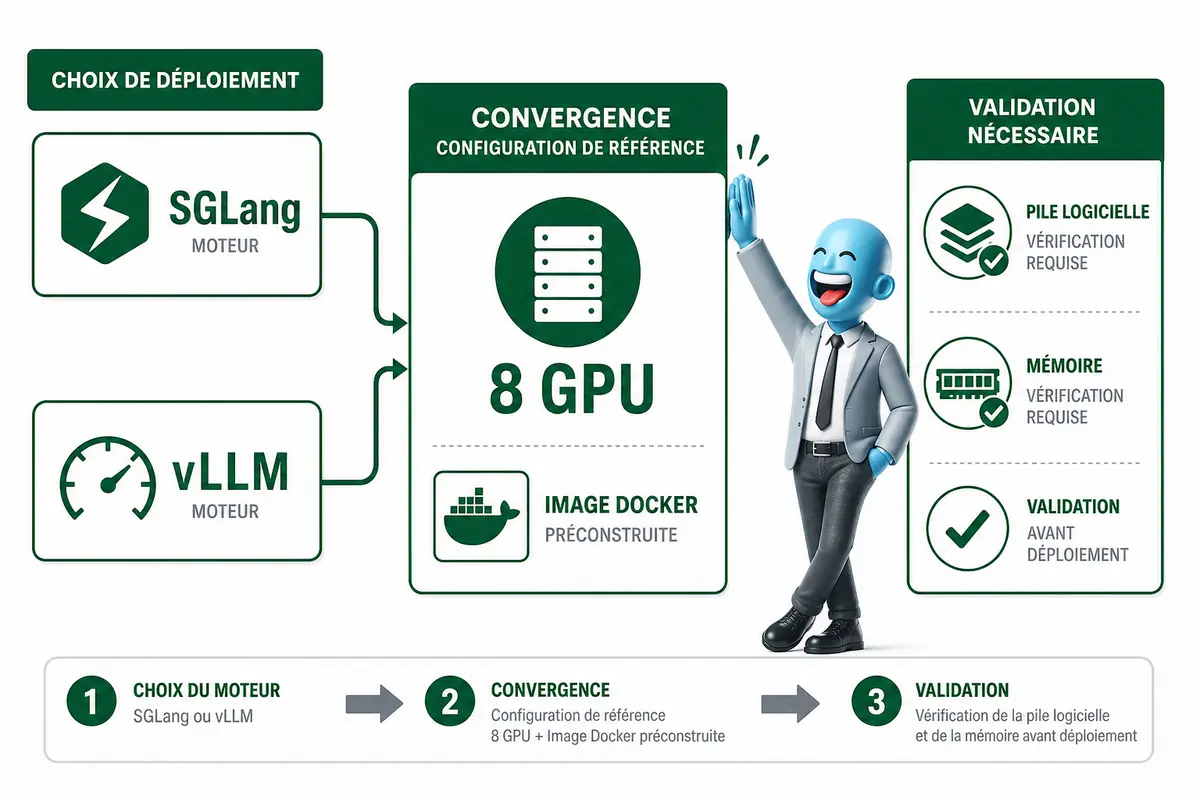
Les éléments de déploiement confirmés sont limités : les commandes de référence configurent le parallélisme sur huit GPU, et IQuest fournit des images Docker préconstruites pour les deux moteurs. Pour SGLang, l’image indiquée est iquestlabworkspace/sglang-iquest-q1:cu130.
Je ne fournis pas de commande de lancement : les informations disponibles ne donnent pas une commande complète et vérifiable. Reconstituer les options de ligne de commande, les paramètres de vLLM, les ports ou les réglages de parallélisme reviendrait à les inventer. Vérifiez ces paramètres dans la documentation officielle actuelle avant toute exécution.
Avant de lancer un conteneur, contrôlez les points suivants sur votre infrastructure :
- La disponibilité des huit GPU requis par la configuration de référence.
- La mémoire GPU disponible pour le modèle et les paramètres de déploiement retenus.
- La compatibilité de l’image Docker choisie avec votre environnement, notamment sa pile logicielle et les capacités matérielles exposées au conteneur.
Ces vérifications ne garantissent pas à elles seules un démarrage réussi. Elles permettent d’écarter les incompatibilités évidentes avant de valider les commandes et paramètres exacts dans la documentation officielle.
| Moteur | Faits établis |
| SGLang | Documenté pour IQuest-Q1 ; image préconstruite : iquestlabworkspace/sglang-iquest-q1:cu130. |
| vLLM | Documenté pour IQuest-Q1 ; une image Docker préconstruite est fournie, sans nom précisé ici. |
| Les deux | Les commandes de référence configurent le parallélisme sur huit GPU. |
Quelles limites vérifier avant le déploiement ?
IQuest-Q1 est un modèle prometteur pour le codage agentique, mais son usage demande une infrastructure conséquente et une validation attentive des résultats. Avant de le déployer, je vérifie les contraintes du modèle et du moteur d’inférence retenu : les capacités annoncées ne garantissent pas une fiabilité suffisante en production.
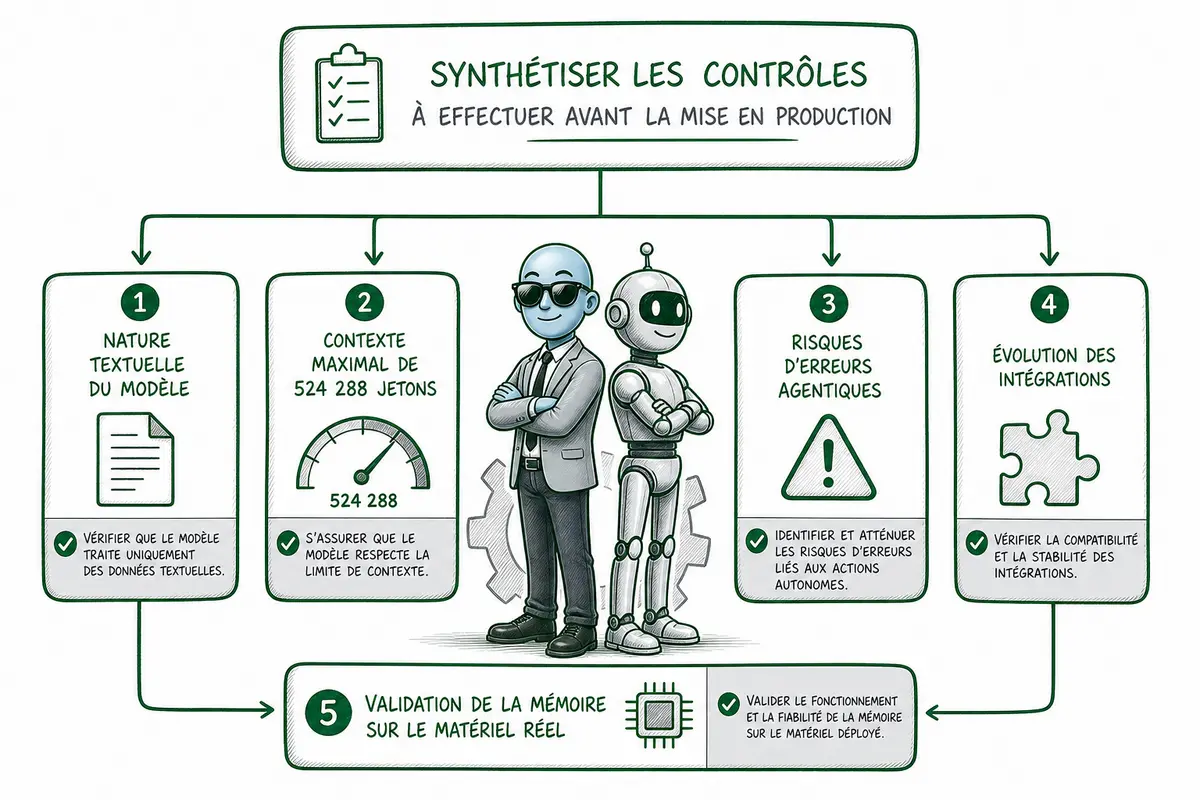
Les limites à intégrer dès le départ sont concrètes :
- Le modèle est uniquement textuel. Il ne traite pas directement les images, l’audio ou la vidéo.
- Il est à un stade précoce. La documentation, les intégrations et la compatibilité avec les moteurs d’inférence peuvent évoluer rapidement.
- Les tâches agentiques peuvent échouer : appels d’outils incorrects, étapes omises ou résultats erronés restent possibles. Une exécution cohérente sur quelques exemples ne suffit pas à valider un workflow.
- La limite de contexte annoncée est de 524 288 jetons. C’est une capacité maximale, pas la preuve qu’une requête de cette taille sera exploitable avec votre configuration ou votre latence cible.
Le nombre de paramètres actifs par jeton ne doit pas être confondu avec la mémoire nécessaire au déploiement. Même si une architecture n’active qu’une partie des paramètres pour chaque calcul, il faut toujours stocker l’ensemble des poids du modèle. La mémoire ne s’arrête pas là : le cache KV, qui conserve les clés et valeurs nécessaires à l’attention pendant la génération, les activations et le composant MTP (« Multi-Token Prediction », utilisé pour prédire plusieurs jetons) ajoutent leurs propres besoins. La mémoire requise varie notamment avec la précision des poids, la longueur du contexte et le nombre de requêtes simultanées.
Je traite donc les capacités annoncées comme des hypothèses à vérifier, pas comme une garantie de qualité ou de débit. Je ne déduis aucune performance de benchmarks sans résultats vérifiables sur la configuration visée. Avant intégration, je consulte la documentation actuelle des moteurs d’inférence, je mesure les besoins mémoire sur le matériel disponible et je teste IQuest-Q1 sur vos tâches réelles, avec des critères d’échec explicites. Si les erreurs agentiques ne sont pas détectées et contenues, le modèle ne doit pas piloter seul un workflow critique.
IQuest-Q1 est-il adapté à votre infrastructure ?
IQuest-Q1 combine une architecture MoE de 320 milliards de paramètres avec environ 15 milliards actifs par jeton, une longue fenêtre de contexte et des mécanismes orientés vers le codage agentique. Cette activation partielle limite le calcul, mais pas la mémoire nécessaire pour les poids, le cache KV, les activations et le modèle MTP. Le déploiement documenté repose sur huit GPU avec SGLang ou vLLM, et des images Docker préconstruites sont disponibles. Les commandes exactes doivent être vérifiées dans la documentation actuelle, car les éléments disponibles ne suffisent pas à fournir une procédure complète fiable. Enfin, le modèle reste précoce et peut se tromper. En évaluant ces contraintes avant déploiement, vous pouvez décider plus vite si IQuest-Q1 convient à votre infrastructure et à vos usages.
FAQ
-
Combien de GPU faut-il pour déployer IQuest-Q1 ?
Les configurations de référence pour SGLang et vLLM utilisent huit GPU. Le modèle nécessite aussi une mémoire importante pour les poids, le cache KV, les activations et le modèle brouillon MTP. -
Pourquoi 15 milliards de paramètres actifs ne suffisent-ils pas à estimer la mémoire ?
Les paramètres actifs correspondent au calcul mobilisé par jeton. Il faut tout de même stocker les quelque 320 milliards de paramètres du modèle, ainsi que les autres éléments nécessaires à l’inférence. -
Quelle est la fenêtre de contexte réelle d’IQuest-Q1 ?
Elle est de 524 288 jetons. L’étiquette client « 1m » mentionnée pour Claude Code ne change pas cette limite réelle. -
Peut-on utiliser IQuest-Q1 avec SGLang ou vLLM ?
Les deux moteurs sont documentés pour le déploiement, avec des configurations de référence sur huit GPU. IQuest fournit des images Docker préconstruites. Il faut vérifier les commandes et paramètres actuels dans la documentation officielle avant le lancement. -
IQuest-Q1 est-il fiable pour les tâches de codage agentique ?
Le modèle est conçu pour le codage agentique, le raisonnement et l’utilisation d’outils en plusieurs étapes, mais il est encore précoce et peut commettre des erreurs. Il faut le tester sur les tâches visées avant de l’intégrer en production.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n et intégration de l’IA en entreprise. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne notamment Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor. Je suis disponible pour aider votre entreprise : contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.