
Les modèles de décision sur image répondent à des questions prédéfinies en analysant directement un scan, un PDF ou une capture d’écran, sans étape OCR. Je détaille leur fonctionnement, leur place dans une chaîne RPA et la gestion des cas incertains, qui restent à vérifier selon le type de question.
Comment ces modèles prennent-ils une décision ?
Le modèle prend une décision en recevant une image et une ou plusieurs questions prédéfinies. Pour chaque question, il interprète directement le contenu visuel et estime la probabilité des réponses possibles. Il ne passe pas d’abord par une étape OCR — une reconnaissance automatique du texte présent dans l’image — avant de répondre.
La sortie peut être comprise comme une distribution de probabilités : chaque réponse candidate reçoit un score, et le modèle privilégie celle qu’il estime la plus plausible au regard de l’image. Si on lui demande, par exemple, si un document est signé, il évalue les réponses possibles à partir des éléments visibles. La décision dépend donc de la question posée et de ce que l’image permet d’observer. Une formulation imprécise ou une image difficile à lire peut rendre le résultat moins fiable.
Le score de confiance indique à quel point le modèle privilégie sa réponse. Il aide à repérer les cas qui méritent une vérification, mais il ne garantit pas que la réponse est juste. Une confiance élevée peut malgré tout accompagner une erreur, notamment si le document est ambigu ou si un détail visuel est mal interprété.
La réponse « inconnu » sert à signaler que l’image ne permet pas de trancher suffisamment, par exemple parce qu’elle est illisible ou ambiguë. C’est utile en production : plutôt que de forcer une réponse catégorique, le modèle peut indiquer qu’une vérification humaine est nécessaire. Je traite cette réponse comme un résultat à part entière, pas comme un échec. Elle permet de distinguer un cas exploitable d’un cas où les éléments visuels ne suffisent pas.
Pourquoi la RPA ne suffit-elle pas toujours ?
La RPA ne suffit pas toujours parce que ses capacités de décision reposent souvent sur des règles et des modèles qu’il faut ajuster à chaque entreprise et à chaque type de document. Dès que les formats, les champs ou les conventions changent, l’automatisation peut perdre en fiabilité.
Un modèle entraîné ou configuré pour reconnaître les champs d’un formulaire standard peut échouer sur une variante pourtant proche : intitulés différents, cases déplacées, mise en page modifiée ou qualité d’image dégradée. Le problème n’est pas seulement de lire le document. Il faut aussi interpréter les éléments dans leur contexte et décider quoi faire lorsque la structure attendue n’est pas respectée.
J’ai souvent vu cette limite lors de déploiements documentaires : le premier cas fonctionne, puis chaque nouveau fournisseur, formulaire ou processus métier demande des règles supplémentaires. Certaines entreprises finissent par maintenir une accumulation de modèles, de seuils et d’exceptions. Chaque cas particulier devient alors un petit projet de modélisation, avec ses tests et ses ajustements. L’automatisation reste possible, mais elle se généralise mal et coûte cher à faire évoluer.
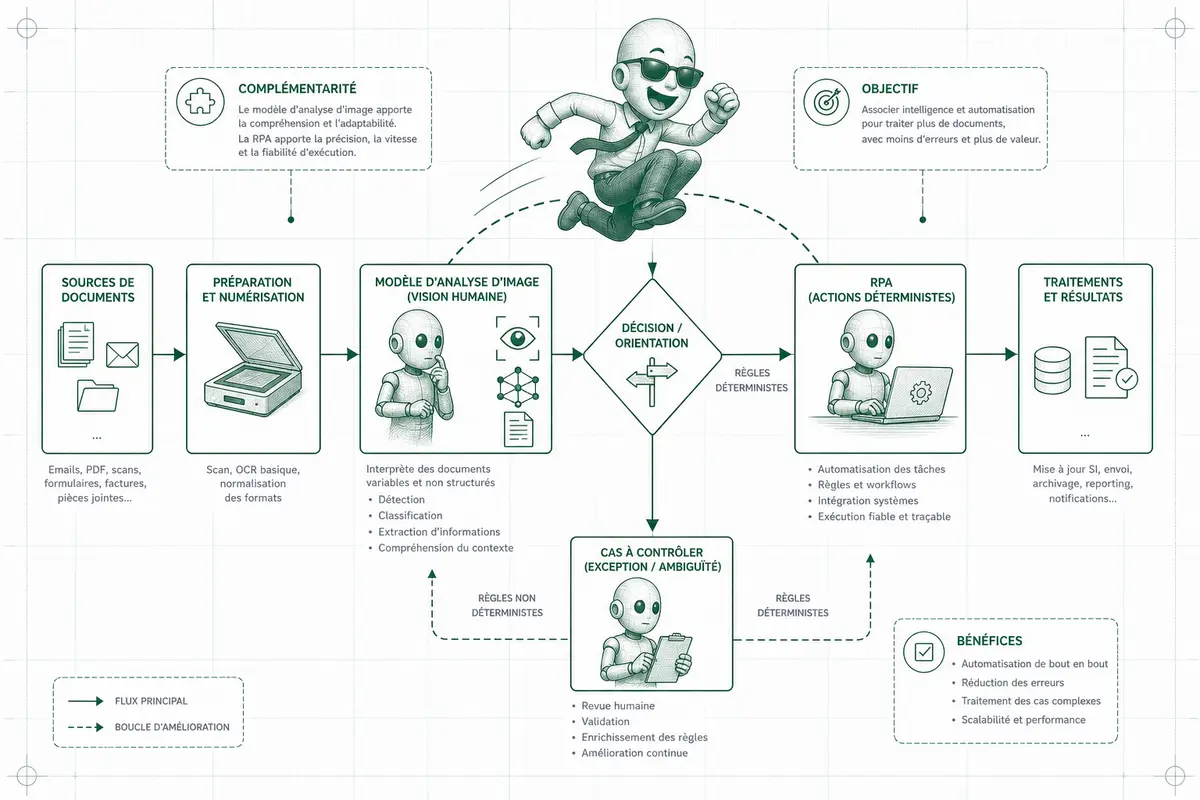
C’est l’intérêt recherché des modèles ouverts et généralistes : ils peuvent traiter des documents variés sans exiger un modèle entièrement spécifique pour chaque formulaire. Ils apportent une capacité d’interprétation plus souple, utile lorsque les formats ne sont pas parfaitement prévisibles. Mais « généraliste » ne veut pas dire fiable sur tout. Un document ambigu, incomplet ou de mauvaise qualité peut toujours produire une réponse erronée. Pour les décisions sensibles, il faut prévoir des contrôles, mesurer la confiance du modèle et transmettre les cas incertains à une personne.
La RPA reste utile pour orchestrer des actions déterministes. Elle atteint ses limites quand la décision dépend d’une interprétation visuelle qui varie d’un document à l’autre. L’enjeu est donc de combiner les deux approches, plutôt que de demander à la RPA de compenser seule toutes les variations documentaires.
Comment traiter les réponses incertaines ?
Je distingue les réponses exploitables des cas incertains avec deux signaux : le score de confiance associé à la réponse et la possibilité explicite de répondre « inconnu ». Le score indique le niveau de certitude estimé par le modèle ; il ne prouve pas que l’interprétation est correcte.
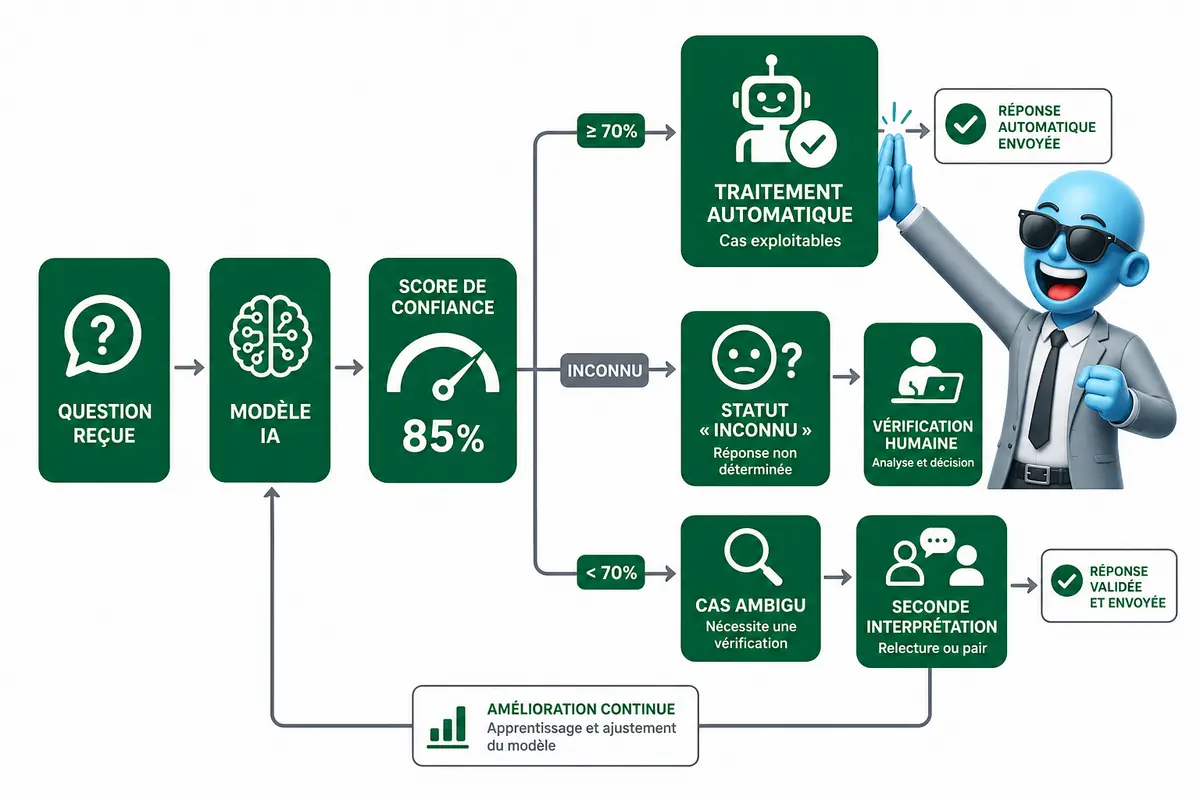
La réponse « inconnu » est utile quand l’image ne permet pas de conclure : document coupé, texte illisible, champ absent ou information visuelle ambiguë. Elle évite de transformer une supposition en donnée exploitable. Le modèle doit pouvoir la renvoyer au lieu de compléter les éléments manquants.
Je traite ensuite les cas incertains sans imposer une décision automatique :
- Une réponse suffisamment étayée peut suivre le traitement prévu pour les réponses exploitables.
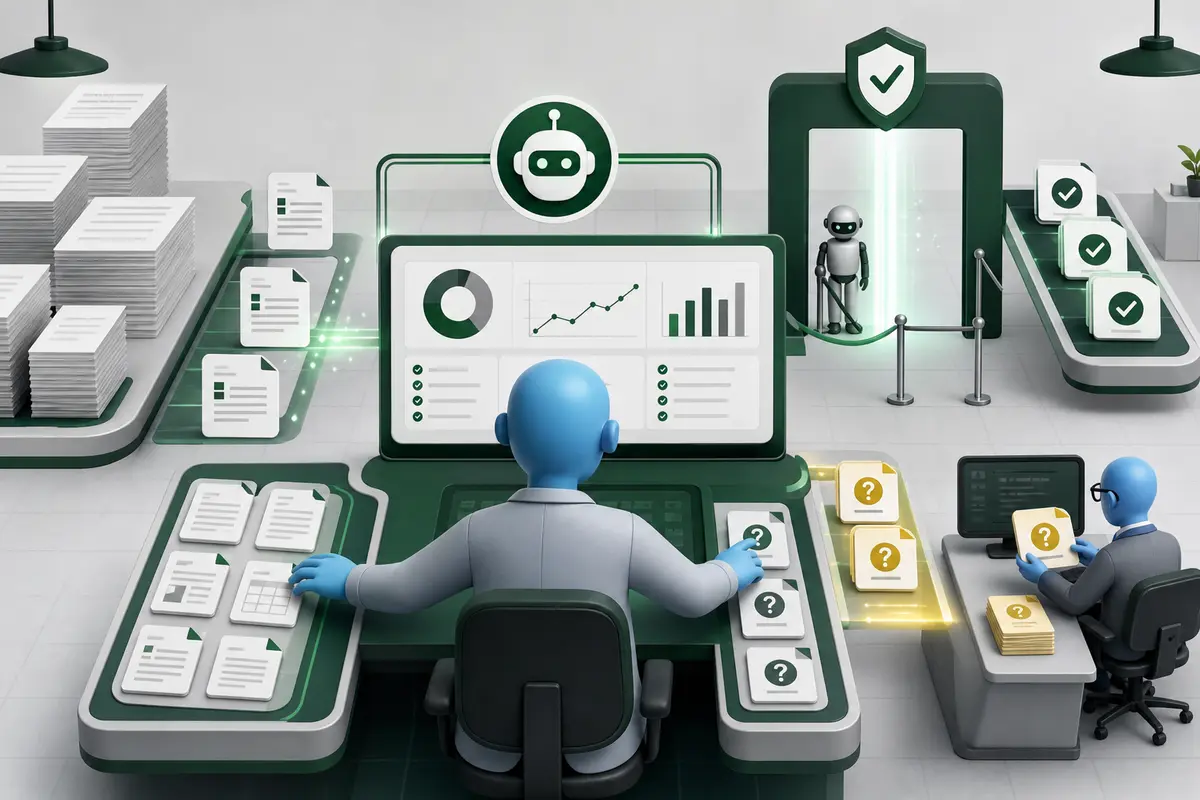
- Une réponse peu sûre, ou « inconnu », peut être orientée vers une vérification humaine. La personne consulte l’image et confirme, corrige ou laisse la valeur indéterminée.
- Le cas peut aussi être soumis à un autre modèle, par exemple pour obtenir une seconde interprétation. Cette réponse reste à évaluer : le recours à un autre modèle ne garantit pas que l’ambiguïté soit levée.
Le score ne doit pas être utilisé seul comme une vérité. Son interprétation dépend du modèle et du contexte d’analyse. Je définis donc les conditions de routage dans le système qui consomme les résultats, sans appliquer de seuil universel. Si les éléments visuels ne suffisent pas, le bon comportement est de suspendre la décision, pas de forcer une réponse.
| Situation | Suite possible du traitement |
| Réponse exploitable avec un niveau de confiance adapté au contexte | Poursuivre le traitement prévu |
| Image ambiguë, incomplète ou illisible | Retourner « inconnu » et orienter le cas vers une vérification humaine ou un autre modèle |
| Interprétation incertaine | Ne pas forcer la décision ; demander une vérification humaine ou une seconde interprétation |
Les modèles ouverts sont-ils adaptés à tous les documents ?
Oui, les modèles ouverts cités, Image-4B et Jev Omni, obtiennent de bons résultats. Mais leurs performances varient selon le type de question posé et les documents analysés. Un modèle peut répondre correctement à certaines demandes et se montrer moins fiable sur d’autres, même lorsque le document est similaire.
Cette variabilité impose d’évaluer le modèle sur vos propres documents et sur les questions auxquelles votre processus doit répondre. Une évaluation pertinente porte sur les usages réels, pas uniquement sur une appréciation générale de la capacité du modèle à lire des images. Les réponses attendues peuvent différer selon que vous cherchez une information précise, une interprétation ou une vérification. Sans cette évaluation, il est difficile de savoir où le modèle est suffisamment fiable pour automatiser une tâche.
Cette limite concerne aussi les approches trop spécialisées. Lorsqu’un dispositif est conçu pour un périmètre étroit, il peut bien traiter les cas prévus, mais être moins adapté dès que les documents ou les questions s’en écartent. À l’inverse, un modèle plus général ne garantit pas une réponse juste dans chaque situation. Le choix ne se résume donc pas à sélectionner un modèle : il faut aussi prévoir quoi faire lorsque la réponse est incertaine.
Je recommande de conserver une voie de vérification pour ces cas. Selon votre processus, une réponse peut être contrôlée par une personne ou soumise à une règle de validation avant d’être utilisée. L’objectif n’est pas de supprimer toute intervention, mais de la concentrer là où la confiance dans le résultat ne suffit pas.
Les modèles ouverts sont donc une option crédible, à condition de valider leur comportement sur vos documents et vos questions, puis de traiter explicitement les incertitudes. C’est cette combinaison entre automatisation et vérification qui permet d’évaluer leur place dans une analyse documentaire par image.
Que faut-il retenir avant d’automatiser ?
Les modèles de décision sur image permettent d’interroger directement des scans, des pages PDF, des captures d’écran ou des photos, sans passer par une étape OCR. Ils renvoient des probabilités et peuvent signaler une réponse incertaine ou inconnue, ce qui aide à orienter les cas ambigus vers une vérification humaine ou un autre modèle. Ils répondent à une limite historique de la RPA, où chaque type de document pouvait nécessiter un ajustement spécifique. Les modèles ouverts comme Image-4B et Jev Omni montrent un potentiel, mais leurs résultats varient selon les questions. Évaluez-les sur vos cas réels et gardez une voie de contrôle : vous automatisez davantage sans imposer de décision aux documents incertains.
FAQ
- Qu’est-ce qu’un modèle de décision sur image ?
C’est un modèle qui analyse une image pour répondre à des questions prédéfinies sur son contenu visuel, par exemple à partir d’un scan, d’une page PDF, d’une capture d’écran ou d’une photo. - Faut-il utiliser l’OCR avant l’analyse ?
Non, le fonctionnement décrit repose sur l’interprétation directe de l’image et ne requiert pas d’étape OCR préalable. - À quoi sert le score de confiance ?
Il accompagne la réponse du modèle et aide à repérer les cas incertains. Une réponse « inconnu » peut aussi signaler une image ambiguë ou illisible. - Que faire lorsqu’une image est ambiguë ?
Le cas peut être orienté vers une vérification humaine ou vers un autre modèle, plutôt que de forcer une réponse. - Les modèles ouverts fonctionnent-ils aussi bien sur tous les documents ?
Pas nécessairement. Image-4B et Jev Omni obtiennent de bons résultats, mais les performances varient selon le type de question.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Analytics, Data engineering et automatisation IA. J’accompagne les équipes dans la conception de workflows fiables, en reliant les capacités des modèles aux contraintes des processus métier et à la gestion des cas qui nécessitent un contrôle.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.